竞争对手的模型正在为谷歌执行优化工作
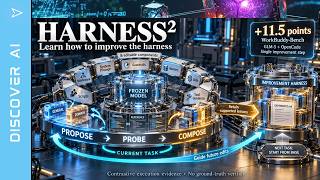
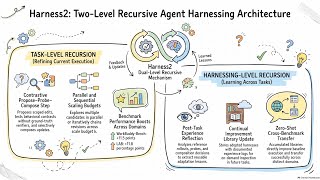
谷歌自身报告中最引人注目的细节是Harness2内部实际负责思考的是谁。被改进的执行代理运行在Gemini 3.5 Flash和GLM-5上,但在谷歌基准测试中,提出并组合每一次架构修改的编辑模型却是由直接竞争对手Anthropic开发的Claude Opus 4.8 [6]。换句话说,谷歌旗舰级的自改进框架在其公布的实验中,依赖竞争对手实验室的模型来生成实际改进。这悄然承认了一个事实:编辑步骤——即决定系统提示、防护规则或技能下一步应如何表述——是一种独特且显然困难的能力,而谷歌在关键时刻并未选择使用自家模型。