Google DeepMind 的 EmbeddingGemma 2 实现设备端多模态嵌入
TECH

Google DeepMind 的 EmbeddingGemma 2 实现设备端多模态嵌入

24+
Signals

战略概览

  • 01.
    Google DeepMind 于 2026 年 10 月 6 日发布了 EmbeddingGemma 2,这是一款拥有 7.4 亿参数的开源模型,采用 Apache 2.0 许可证发布,能够将文本、代码、图像、视频和音频映射到一个共享的 768 维嵌入空间中。
  • 02.
    这 7.4 亿参数分布在三个编码器中——一个 2.7 亿参数的文本模型(包含 1.3 亿参数的 Transformer 主干网络和 1.4 亿参数的嵌入器)、一个 1.7 亿参数的视觉编码器和一个 3 亿参数的音频编码器——全部投影到同一个共享空间中。
  • 03.
    在 Google Pixel 11 Pro 上,量化后的权重在仅处理文本时占用约 191MB 活跃内存,在完整多模态版本中则占用 567MB 内存,并支持 8,000–8,192 token 的上下文窗口——是原始 EmbeddingGemma 的四倍,同时支持 Matryoshka Representation Learning(MRL),可将 768 维向量截断为 512、256 或 128 维。
  • 04.
    在 MTEB Code 基准测试中,EmbeddingGemma 2 得分为 78.68,比原始 EmbeddingGemma 的 68.76 提高了 9.92 分。

三个编码器,一个向量空间:EmbeddingGemma 2 背后的机制

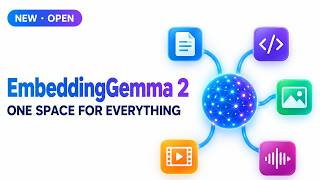
EmbeddingGemma 2 最引人注目的特点并非单一更大的模型,而是三个独立训练但最终落在同一坐标系中的编码器。总共 7.4 亿参数被划分为一个 2.7 亿参数的文本模型(1.3 亿参数的 Transformer 主干网络加 1.4 亿参数的嵌入器)、一个 1.7 亿参数的视觉编码器和一个 3 亿参数的音频编码器,每个编码器将其对应模态的数据投影到相同的 768 维空间 [1]。正是这种共享的几何结构使得文本查询、照片和视频片段可以通过简单的点积进行比较,而无需事后拼接多个独立的检索系统。

第二个值得理解的机制是 Matryoshka Representation Learning(MRL),它训练嵌入向量使其前 512、256 或 128 维度本身仍具有实用性——而不仅仅是完整的 768 维。结合 8,000–8,192 token 的上下文窗口(是原始 EmbeddingGemma 的四倍),这使得同一模型既能索引短代码片段,也能处理足够长、需要真实检索的文档块 [2]。在 MacBook M5 Pro GPU 上,视觉编码每张图像耗时 37.3 毫秒,对 500 个候选选项的决策路由任务可在 100 毫秒内完成——速度足以让该嵌入器作为零样本意图路由器使用,而不仅仅是一个搜索索引 [3]。

其优势在代码检索方面表现最为明显,EmbeddingGemma 2 在 MTEB Code 基准测试中从 68.76 跃升至 78.68,提升了 9.92 分,这一提升超过了模型其他大多数改进,表明架构变化而不仅仅是更多训练数据正在发挥实际作用 [4]。
Google 不再掩饰的权衡:效率优先于排行榜质量

EmbeddingGemma 2 值得注意的地方不在于它声称了什么,而在于它没有声称什么。在整个更广泛的基准测试套件中——MTEB 多语言得分为 61.36,MMEB v2 图像检索得分为 57.28,视频检索得分为 50.67,MSEB 音频检索得分为 69.54——这些分数对于一个 7.4 亿参数的模型来说算是稳健,但并未达到新的最先进水平 [5]。Google 自身的定位强调的是‘同尺寸中最佳’而非‘整体最佳’,这个限定词至关重要。

发布当天的开发者社区从另一个角度捕捉到了同样的权衡。在发布后的社区讨论中,有评论者指出,根据 Google 自己的基准对比,该模型在通用文本检索质量上并不优于 Qwen3-Embedding-8B,只是显著更小且运行成本更低。另一位评论者说得更直白:在强大 GPU 上运行的 Qwen3-8B 在纯文本任务上将‘大幅超越’EmbeddingGemma 2。Google 明确提出的交易是——放弃一些性能上限,换取一个能在手机上以几百兆内存运行、而无需 GPU 服务器的模型。

两千万次下载的赌注:为何走向多模态

EmbeddingGemma 2 并非凭空出现——它的存在是因为大约一年前发布的初代 EmbeddingGemma(一个纯文本模型)下载量已超过 2,000 万次,成为设备端搜索和注重隐私的检索增强生成(RAG)的默认选择 [6]。这一采用数字才是本次发布的真实前提:它告诉 Google DeepMind,开发者对小型、离线、可授权嵌入器的需求足够强烈,足以证明构建一个更重、多模态的继任者是合理的,而不是仅仅迭代文本质量。

这一赌注的经济性直接体现在存储计算中。MRL 截断技术可使向量数据库从完整的 768 维下每百万向量约 1.5GB 存储缩减至 128 维下的约 250MB——减少 6 倍——而在 256 维设置下仍能保留接近 95% 的检索质量 [6]。对于大规模运行嵌入的任何人来说,这决定了向量索引能否完全放入内存,相比多模态这一标题本身,这是一个更具体的‘为何现在推出’的理由。

生态系统首日即支持——并在数小时内发现首个陷阱

发布后数小时内,EmbeddingGemma 2 已获得 sentence-transformers(6.1.0+)、MLX、vLLM、llama.cpp、SGLang、Ollama 和 LM Studio 的支持 [7],Gemini Enterprise Agent Platform Model Garden 列表也即将上线。这种速度并非偶然——初代 EmbeddingGemma 的下载量已经让整个生态系统预期并提前为续作做好准备,因此 llama.cpp 和 GGUF 转换几乎立即完成,而非数周之后。

实践者也迅速发现了粗糙之处。社区讨论中最常重复的建议是始终一致地应用模型的任务前缀约定(区分‘query’嵌入和‘document’嵌入)——跳过此步骤会被标记为降低检索质量。第二条建议关于 MRL 本身:当将 768 维向量截断至 128 或 256 维时,社区建议应先将向量切片至目标长度,然后重新归一化(L2 归一化),而不是在切片前归一化。这两条建议都是经验丰富的用户在发布日讨论串中最早传递给新手的内容。

历史背景

发布了最初的纯文本 EmbeddingGemma 用于设备端使用;该模型随后下载量超过 2,000 万次,成为设备端搜索和注重隐私的 RAG 流水线的流行基础。
发布了 EmbeddingGemma 2,将最初的纯文本模型扩展为基于 Gemma 4 架构的原生多模态嵌入模型,参数数量超过前代模型一倍以上。

关键关系图

关键玩家
主题

Google DeepMind 的 EmbeddingGemma 2 实现设备端多模态嵌入

GO

Google DeepMind

EmbeddingGemma 2 的开发者和发布者;通过其官方博客和 X 账号宣布该模型,并将其定位为原始 EmbeddingGemma 的设备端继任者,直接掌控模型的架构、许可证以及集成到其 AI Edge、ML Kit 和 MediaPipe 工具链中。

HU

Hugging Face

EmbeddingGemma 2 模型权重的主要第三方托管平台,包括设备端优化的 LiteRT Community 构建版本——这是 Google 自身工具链之外的开发者获取该模型的主要渠道。

KA

Kaggle

EmbeddingGemma 2 权重的次要官方托管平台,将分发范围扩展至 Google 现有的基于 Kaggle 的机器学习社区。

TH

The open-source inference ecosystem (sentence-transformers, llama.cpp, vLLM, Ollama, MLX, LM Studio, SGLang)

共同决定了 Google 之外的开发者运行该模型的速度和成本;这些运行时在发布首日的支持,使得 Apache 2.0 权重发布能够真正转化为可在商用硬件上使用的工具。

GO

Google AI Edge, ML Kit, and MediaPipe

Google 自身的设备端机器学习栈,将 EmbeddingGemma 2 集成到面向消费者的功能中(如 Instant Media Search、Video Moments Finder、Foresight 会议助手),并将通过 NPU 加速带入 ML Kit——这是 Google 如何部署该模型本身的最明确信号。

事实来源

8 条引用
  1. [1] Google DeepMind Launches Multimodal AI Model For On-Device Search
  2. [2] Introducing EmbeddingGemma 2: A Best-in-Class Open Model for Natively Multimodal Embeddings
  3. [3] Google AI Edge with EmbeddingGemma 2
  4. [4] Google Launches EmbeddingGemma 2 For On-Device Multimodal Search
  5. [5] DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space
  6. [6] Google Expands EmbeddingGemma Beyond Text to Images, Audio and Video
  7. [7] EmbeddingGemma 2
  8. [8] EmbeddingGemma 2: The Developer Guide

来源文章

Top 5

THE SIGNAL.

Analysts

“将 EmbeddingGemma 2 描述为设备端多模态嵌入功能最强的模型,基于与 Gemini 嵌入模型相同的技术构建,并声称其在参数低于 10 亿的多模态嵌入器中取得了领先分数。”

Google DeepMind (Sahil Dua and Henrique Schechter Vera)
研究工程师,Google DeepMind,来自官方发布博客

“将该模型与其他强大的开源发布进行比较,称其接近 GLM-5.2 水平,可能是目前可用的最佳美国开源模型。”

Unnamed Ph.D. researcher (aggregated via Techmeme)
独立评论员

“指出早期基准反应低估了该模型,直到人们将其较小的参数数量和效率与其得分进行权衡后才有所改观。”

Unnamed analyst (aggregated via Techmeme)
独立评论员
The Crowd

“Introducing EmbeddingGemma 2, a new open multimodal model that sets the standard for on-device efficiency. - our first open, natively multimodal embedding model - handles text, code, image, video, and audio tasks within a lightweight, modular 740M parameter form factor - ideal”

@@sundarpichai5506

“Meet EmbeddingGemma 2, our first natively multimodal open model for on-device embeddings. It expands beyond text to unify code, images, audio, and video in a shared space.”

@@GoogleDeepMind3047

“Introducing EmbeddingGemma 2! Our lightweight, multimodal embedding model maps text, code, images, video, and audio into a single, unified embedding space. Optimized for on-device use cases.”

@@googlegemma2531

“Google releases EmbeddingGemma 2”

@u/yoracale577
Broadcast
Introducing EmbeddingGemma 2: An open model for natively multimodal embeddings

Introducing EmbeddingGemma 2: An open model for natively multimodal embeddings

EmbeddingGemma 2 Explained: One Embedding Space for Text, Images, Video & Audio

EmbeddingGemma 2 Explained: One Embedding Space for Text, Images, Video & Audio

Google's EmbeddingGemma 2: Search Your Files Like Never Before

Google's EmbeddingGemma 2: Search Your Files Like Never Before