从流水线到统一视频到视频:Griffin如何实现全双工逼真性
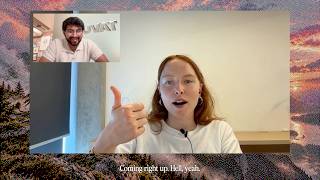
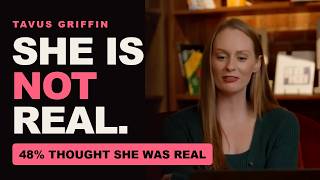
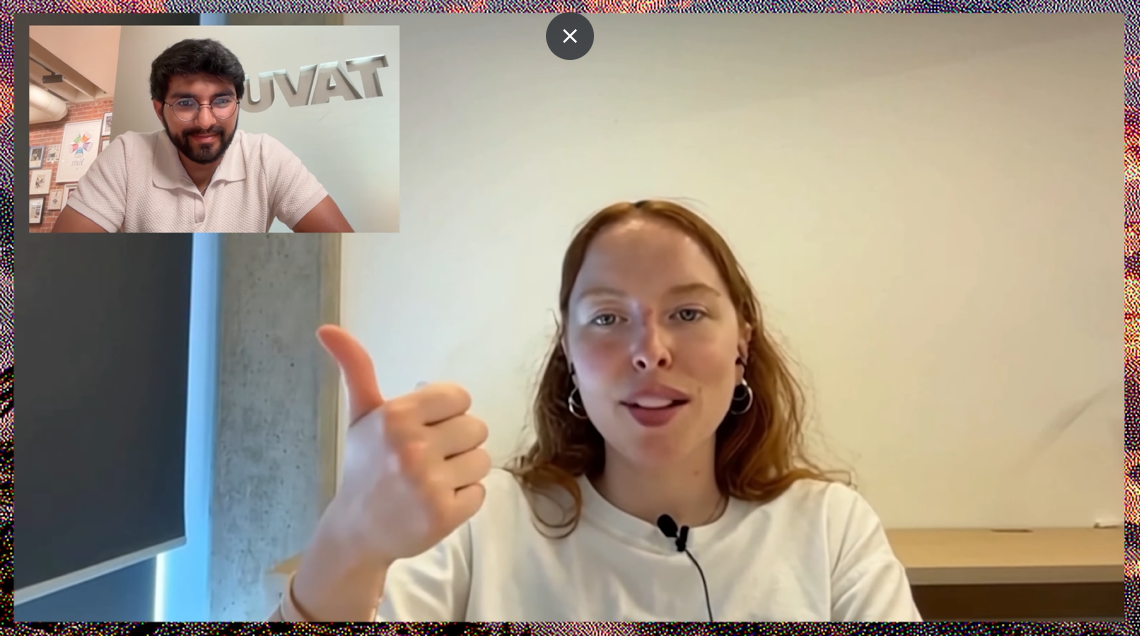
Tavus构建Griffin的目的是用单一的视频到视频系统取代传统的语音识别、语言模型、语音合成和头像渲染组件的拼接流程[1]。这种整合正是实现全双工行为的关键——Griffin不再等待说话人说完再生成回应,而是每秒多次持续重新评估对话,使其能够进行反馈、容忍打断,并像真实电话一样追踪沉默时长[2]。Tavus自身的发布材料并未回避这种自我意识,反而加以利用:其官方演示视频设计为一场视频通话,其中一位参与者最终被揭示为AI,对话中调侃‘很快就能通过图灵测试了’,并以‘别再解释了,直接展示给他们看’作为整个发布的宣传点;而更传统的BusinessWire新闻稿视频则以正式方式报道了同一消息。自然性也体现在更细微、即兴的瞬间——一位早期测试者描述自己发烧时与Griffin通话,模型回应‘哦不,Kai,发烧最难受了’,并询问他是否服了药,这种情境化的反应是传统组件拼接流程难以即兴实现的。硬数据也印证了这一点——Griffin-Lite通过流式自回归扩散模型以320毫秒为单位流式传输720p视频,在NVIDIA H100芯片上平均音频到视频延迟为0.43秒[1][4]。按此衡量,它似乎比Tavus此前的Phoenix-4.5模型更慢,后者宣称延迟为134毫秒,并被宣传为市场上最快[7]——尽管这两个数字可能衡量的并非同一指标,因为Griffin的指标描述的是端到端音频到视频响应时间,而Phoenix-4.5描述的是每帧渲染延迟。即使考虑到这一点,Phoenix-4.5在类似研究中仅欺骗了2.4%的参与者,因此显然仅靠速度无法解释可信度;对话时机和多模态一致性似乎更为重要。