CPU机架的反击:为何智能体AI不再需要更多GPU
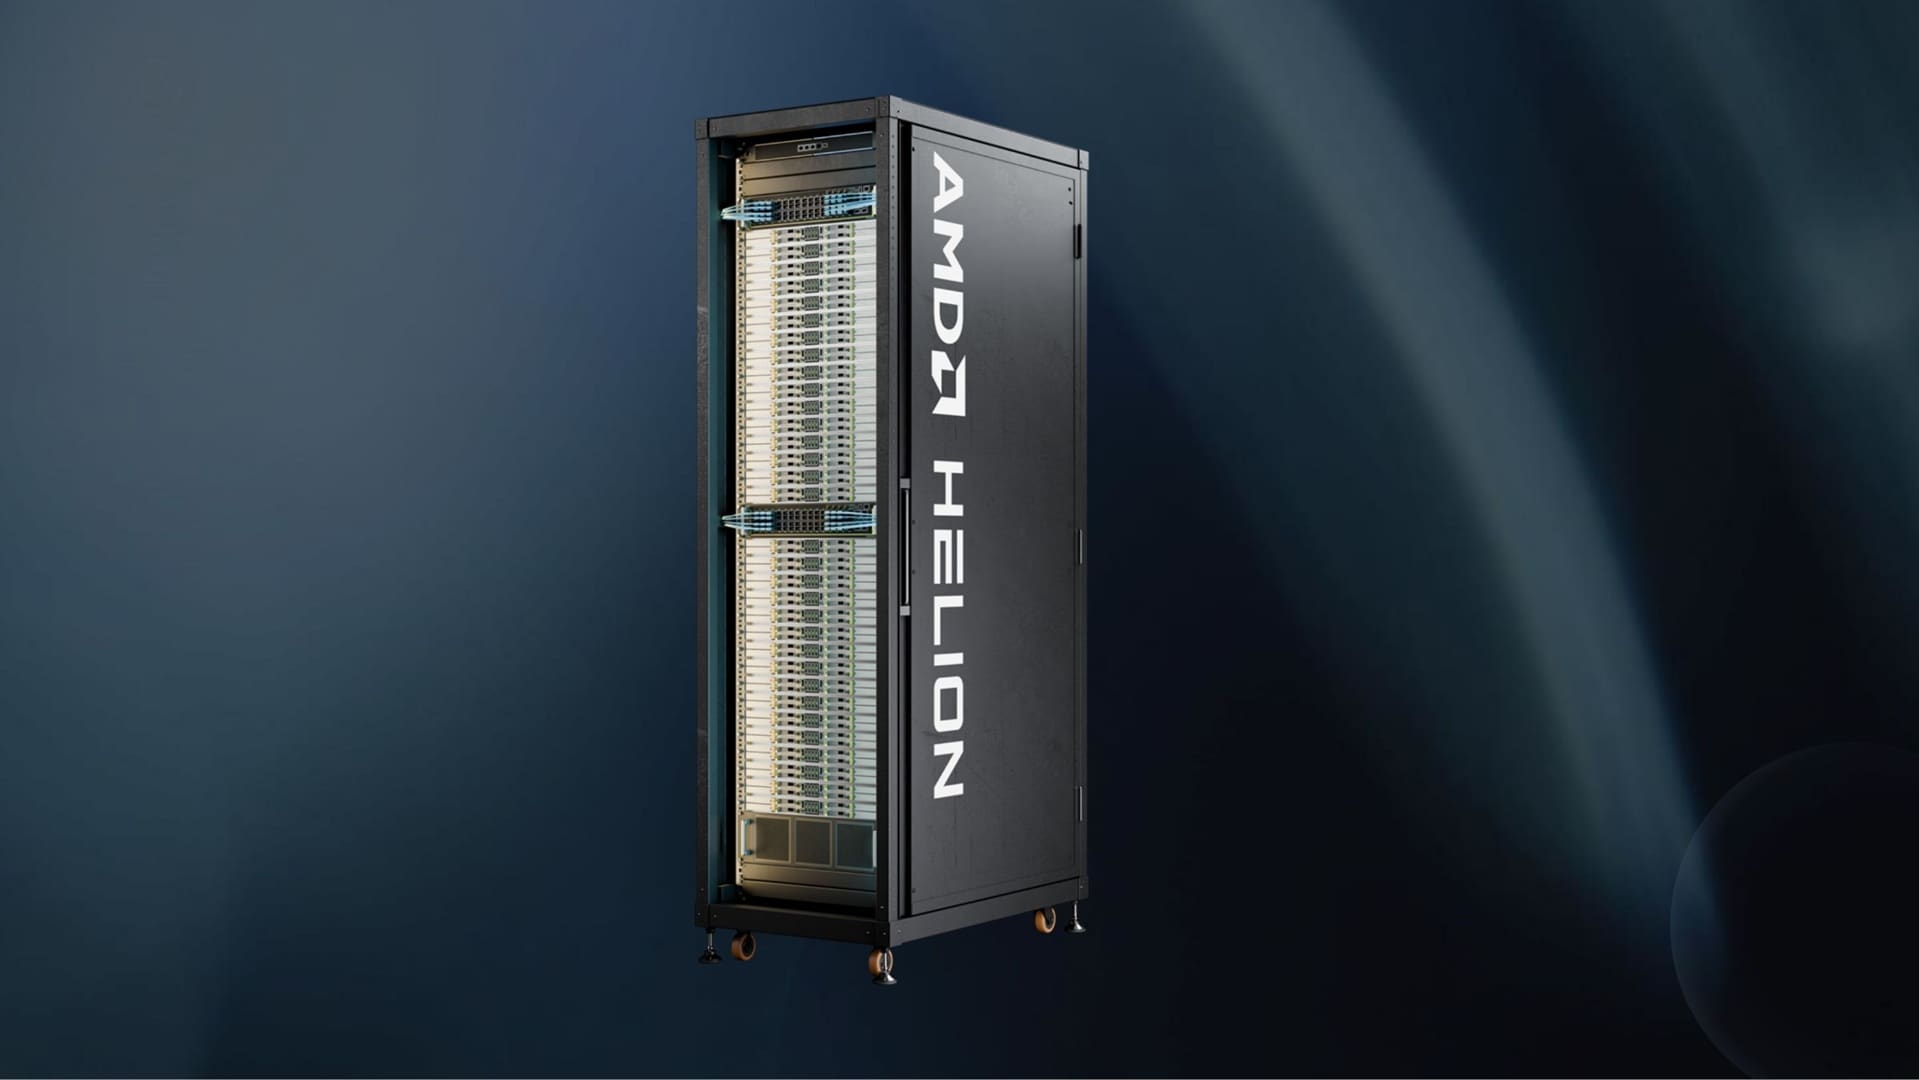
十年来,“更多AI算力”意味着“更多GPU”。而Helion却悄然提出了不同观点。AMD的纯CPU配置将多达32,768个Zen 6 EPYC核心塞进一个开放计算项目(Open Compute Project)机架中,完全不使用任何加速器[1],这表明一部分重要的智能体AI工作负载——如规划、工具调用、编排、检索——本质上是CPU密集型任务,GPU无法提供帮助。AMD首席执行官苏姿丰在OCP全球峰会2026的主题演讲中明确表达了这一理念[2]:“并非每个问题都需要相同的算力。你需要为不同的应用匹配合适的模型和合适的算力。”
这一主张比听起来更具颠覆性。Omdia分析师Lian Jye Su预计,智能体AI将推动加速器与CPU的比例从大约16:1向接近1:1转变,因为智能体工作流的编排和代码执行将逐渐取代原本几乎完全由GPU主导的需求[3]。Gartner的Kanishka Chauhan对这一创新性持更怀疑态度,他认为Helion的CPU/GPU分离只是反映了企业已有的工作负载划分,而非一种根本性的新架构——尽管他承认,一旦智能体工作流运行时间变长,机架间延迟就会成为真正的瓶颈[3]。独立地,Reddit上的硬件讨论区在没有AMD引导的情况下也得出了类似结论:评论者反复指出,始终在线的智能体和强化学习 rollout 工作负载——成千上万次智能体尝试被评分和强化,而非一次性的预训练——才是最初真正需要如此大量专用CPU资源的用例。