纸面SOTA,实践中表现不均
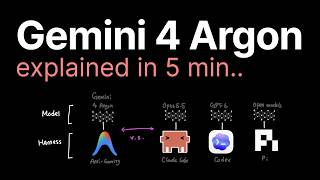
谷歌自己的对比表格显示,Argon 在与 Claude Opus 5.5、Claude Fable 5.1 和 GPT-6 Astra 的19项基准测试中赢得了13项 [1],并且与 LMArena 的文本竞技场和创意写作类别并列 Vals Index 排行榜榜首 [2]。但一旦你超越排行榜,这一成绩就显得脆弱:关于发布的报道发现,Argon 在 FrontierSWE v2 和 Terminal-Bench 4.0 代理编码基准测试中均垫底,并在 LMArena 的独立 WebDev 类别中排名第九 [3]。同一报道援引未具名的谷歌员工指出,Argon 在现实世界的编程和前端设计任务中的表现不如其基准测试成绩所暗示的那样好,这被标记为可能的‘benchmaxxing’案例——即优化测试套件而非通用能力 [3]。在更难的事实回忆问题上,Argon 的正确率仅为50%,而 GPT-6 Astra 为63% [3]。这种衡量智能指数与实际可靠性之间的分裂,是本次发布的核心矛盾。一个广受关注的 YouTube 解说视频,Caleb Writes Code 的‘Gemini 4 Argon 5分钟讲解’,进一步复杂化了编码基准的故事:它给予 Argon 在 SWE-bench 风格的编码测试中77.9%的分数,领先于所有其他当前模型,但指出 Epoch AI 在同一基准中识别出23个错误任务,且完整的113个问题集已公开数月——这意味着后期发布的实验室,包括谷歌,可能在泄露的解决方案上进行训练,从而人为抬高后期发布者的分数。这是一个具体且独立来源的理由,让我们以同样的怀疑态度看待上述13比19的成绩单,正如对待现实编码差距一样。