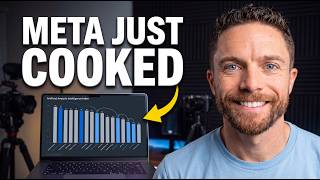
Meta自身的基准测试与独立评分结果大相径庭
Meta自身公布的基准数据与第三方验证对Muse Wonder的实际表现给出了截然不同的说法。在《人工分析智能指数》v4.3中,Muse Wonder Full得分为56,较轻量版的Muse Wonder得分为52,相比之下,Claude Opus 5.5得分为58,Claude Sonnet 5.5为56,GPT-6 Astra为53——这意味着Wonder Full与Sonnet 5.5持平,但Opus 5.5仍领先[1]。在《人工分析编码代理指数》中,Wonder Full在最大努力下达到68分,与基于Sonnet 5.5的Claude Code持平,而其代理任务性能在Terminal-Bench 4.0中从上一代模型的33%跃升至57%[1]。Wonder Full在数学证明基准测试ProofBench上解决了100道题中的94道,远超前代的58道,Meta还报告其幻觉率从33%降至23%[1]。Meta在发布材料中将此次发布描述为‘我们在扩展阶梯上的下一步,是迈向个人超级智能的重大飞跃’[2]。这种自我有利的表述也出现在Meta的内部指标中:其‘个人超级智能指数’声称Wonder Full得分为59.1,领先于Claude Opus 5.5和GPT-6 Astra;其‘SWE马拉松’指标则将Wonder Full定为57.5分,远超Opus 5.5的46.3分——这两个基准均由Meta自行创建,而独立的《人工分析智能指数》仍将Wonder Full定为56分,落后于Opus 5.5的58分。一项独立编码基准测试揭示了更严峻的现实:BridgeBench仅给Muse Wonder评出611分——在29个测试模型中位列第8,比榜首低149分[3]——该基准运营方公开指责Meta操纵其自报分数。厂商自报与独立验证结果之间的差距,才是此次发布背后真正的关键故事。