Vera Rubin为何胜出:NVFP4精度与专用硅芯片的结合
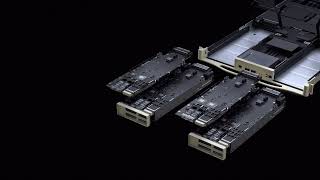
Vera Rubin NVL72相对于GB300 NVL72的吞吐量优势,源于硬件与软件的协同改进,而非单一技巧。NVIDIA表示,其增强的张量核心和Transformer引擎加速了推理的prefill和decode两个阶段,而NVFP4精度则缩小了模型权重、注意力机制和KV缓存的内存占用——从而在输出质量几乎无损的情况下提升吞吐量[1]。这些软件增益建立在一个集成了72颗Rubin GPU和36颗Vera CPU的机架之上,配备20.7 TB HBM4 GPU内存、1,400 TB/s GPU内存带宽和216 TB/s NVLink带宽,NVFP4推理算力达3,600 PFLOPS[2]。DeepSeek-R1的结果(2.5倍)在离线、服务器和交互场景下均通过TensorRT-LLM实现,而更大的Qwen3-VL增益(3.7倍)则使用了vLLM与NVIDIA Dynamo的组合——这提醒我们,所宣称的飞跃实际上是针对不同工作负载形态优化的两套独立堆栈,而非一个通用倍数。