NVIDIA的Nemotron 3.5模型家族发布
TECH

NVIDIA的Nemotron 3.5模型家族发布

34+
Signals

战略概览

  • 01.
    NVIDIA发布了Nemotron 3.5 Super VL,这是一款开源的1200亿参数多模态专家混合模型(总计1200亿,每个token激活约120亿至130亿参数),专为持续运行的专用AI代理设计,同时发布了两款边缘模型:Bolt 74B-A9B(24GB)和Bolt E4B(4GB)。
  • 02.
    Super VL结合了推理与工具使用能力,支持文本、图像、文档和视频理解,训练数据包含约26万亿个token以及380万个强化学习样本。
  • 03.
    Super VL和Bolt 74B-A9B现已发布(2026年10月15日);Bolt E4B计划于2026年10月23日跟进发布。
  • 04.
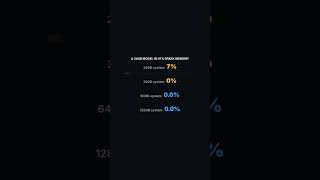
    Bolt 74B-A9B采用原生2比特量化技术,可在24GB内存中运行本地代理工作负载;Bolt E4B则面向RTX、Jetson和RTX/DGX Spark设备上的快速对话代理。
  • 05.
    这些模型采用OpenMDW-1.1许可证发布,允许商业使用、微调和再分发,并涵盖权重、训练数据和训练方法。
  • 06.
    发布首日即通过vLLM、llama.cpp、Ollama和LM Studio提供支持;由于Nemotron采用了混合Mamba-2/注意力架构,必须使用vLLM 0.27.1及以上版本。
  • 07.
    Super VL和Bolt与此前发布的Lightning(2026年8月11日发布)及Ultra共同组成完整的Nemotron 3.5家族,覆盖从数据中心到桌面的部署场景。
  • 08.
    Super VL在代理任务中的吞吐量比其他开源模型最高提升5倍,每秒输出超过600个token,在编码任务中任务完成速度提升4倍。

架构押注:效率优先于前沿规模

Nemotron 3.5家族的大多数模型都依赖相同的效率逻辑:采用专家混合设计,每个token仅激活部分总参数——Super VL、Lightning和Bolt 74B-A9B已确认如此,尽管NVIDIA尚未公布Bolt E4B或Ultra的激活参数分解。Super VL拥有1200亿总参数,但每个token仅激活120亿至130亿 [1],训练数据包含约26万亿个token和380万个强化学习样本 [12]。这种效率比例贯穿整个产品线——Lightning为300亿总参数、30亿激活;Bolt 74B-A9B为740亿总参数,仅90亿激活,并通过原生2比特量化进一步压缩,使整个模型可容纳于24GB内存中。训练方法是后训练故事的关键:NVIDIA报告称,在狭窄任务上的微调性能提升达9%至44%,例如将安全攻击抵御能力的准确率从35%提升至76% [1]。Super VL的混合Mamba-2/注意力层也意味着该模型无法直接接入任意推理框架——必须使用vLLM 0.27.1或更高版本,因为旧版服务引擎未编译Mamba-2内核 [2],多家媒体指出这是团队在首日尝试自托管时最可能遇到的实际障碍。
无人宣传的基准差距

NVIDIA的发布材料极力强调与前沿闭源模型的直接对比胜利,媒体报道重点突出其声称微调后的Super VL在专用基准测试中击败Claude Opus 5和GPT-6.1 Sol [3]。NVIDIA自己的数据也支持这一说法:在狭窄任务上,例如医疗理赔准确率从28%提升至72%,优于Claude Opus 5在同一测试中的约38% [1]。但这种说法仅在狭窄微调任务中成立。在Artificial Analysis的更广泛智能指数中,Super VL得分为26,而Claude Opus 5.5为58 [4],不足一半,这一差距削弱了将Nemotron 3.5视为通用前沿竞争者的任何解读。Artificial Analysis自身的分析反而将其定位为领先的美国开源权重模型 [5],这一说法比基准幻灯片所暗示的更为狭窄且更具可辩护性。结论是:Nemotron 3.5旨在赢得企业为其微调的特定任务,而非在所有方面超越闭源前沿模型——这正是MoE效率押注所设计的权衡。

免费权重,付费支持:NVIDIA的硬件引流策略

NVIDIA将开源发布定位为战略举措而非慷慨行为。CEO黄仁勋(Jensen Huang)表示,免费AI应有利于硬件和芯片 [6],The Decoder的分析明确指出:Nemotron的严肃生产部署仍需购买NVIDIA GPU,因此免费提供权重实质上是为底层芯片创造需求 [4]。报道称,NVIDIA在开源权重模型上的投资约为五年260亿美元 [7],而“免费”框架存在上限——尽管权重本身可免费下载,但生产级支持需要每年每GPU 4,500美元的NVIDIA AI Enterprise许可证 [3],这意味着一个免费下载的模型在规模化部署时仍会持续为NVIDIA带来收入。报道还指出,此次发布的时机与来自中国开源权重实验室(如DeepSeek和Moonshot.ai)的竞争压力有关 [5],表明开源权重的推动既是为了争夺这一赛道,也是出于内部硬件经济的考量。

企业胜利与社区质疑并存

早期企业用户报告了显著的实际收益:Scale AI的Skydance供应商信用代理称推理成本降低约40倍,延迟降低5倍;Ramp在收据处理中报告吞吐量提升50%,延迟降低10倍;AI21的网络安全产品Alice在微调Super VL后,威胁分析准确率提升约40% [1]。CrowdStrike作为NVIDIA AI设计合作伙伴,正在基于该系列构建安全代理;Salesforce则单独定制Nemotron以自动化政府工作流程 [8][9]。然而,这种企业乐观情绪并未完全反映在动手实践的爱好者群体中。社区对Bolt 74B-A9B的测试持怀疑但好奇态度:尽管对其2比特量化感知技术能将740亿参数模型压缩至24GB内存感到兴奋,但对NVIDIA模型质量记录的不信任依然存在,且普遍抱怨将90亿激活参数的MoE模型与270亿级密集模型进行对比并不公平,因为MoE本质上是以牺牲原始智能换取速度。一种广为流传的理论认为,NVIDIA故意将Nemotron保持在低于前沿水平,以避免蚕食自身的企业GPU销售,值得注意的是,该发布恰在RTX Spark发布前一天。独立测试发现,较小的Lightning模型在不同硬件上与密集300亿模型相比,吞吐量表现不一,并非始终具有速度优势;此外,该模型在明确指令下仍默认使用Python而非C语言——这虽是小细节,但为该系列“专精非前沿”的定位提供了具体佐证。

历史背景

首次公开发布Nemotron品牌模型(Nemotron-3 8B)。
发布Nemotron 3 Nano(300亿,约30亿激活)。
发布Nemotron 3 Super(约1000亿,约100亿激活),用于多代理应用。
发布Nemotron 3 Ultra(5500亿),作为NVIDIA首款前沿规模的开源权重模型。
发布Nemotron 3.5 Lightning,作为3.5系列首款模型,专为长期运行的代理设计。
发布Nemotron 3.5 Super VL和Bolt 74B-A9B;宣布Bolt E4B将于10月23日发布,完成3.5家族(Lightning、Super VL、Bolt、Ultra)布局。

关键关系图

关键玩家
主题

NVIDIA的Nemotron 3.5模型家族发布

NV

NVIDIA

Nemotron 3.5家族的模型开发者和发布方

SC

Scale AI

将Super VL适配用于Skydance的供应商信用处理代理;报告推理成本降低约40倍,延迟降低5倍

CR

CrowdStrike

作为NVIDIA AI设计合作伙伴,为企业的蓝队攻防定制该模型

SA

Salesforce

通过Missionforce Operations定制Nemotron,以驱动自动化政府工作流程的AI代理

RA

Ramp

使用该模型将收据照片转换为结构化数据;报告吞吐量提升50%,延迟降低10倍

AI

AI21 (for Alice)

为网络安全公司Alice微调Super VL用于威胁与漏洞分析;报告准确率提升约40%

EY

EY, Hebbia (AfterQuery), Mercor, Dream, Lila Sciences, R1

其他定制Super VL的企业合作伙伴

AT

Atlassian, Dassault Systemes, Perplexity, Synopsys

集成Nemotron模型的平台方

NE

Nemotron Coalition (Mistral AI, Thinking Machines Lab, Perplexity, Black Forest Labs)

NVIDIA为推进开源前沿模型发展而组建的协作组织

JE

Jensen Huang (NVIDIA CEO)

公开倡导开源权重的Nemotron战略作为硬件需求驱动器

事实来源

12 条引用
  1. [1] NVIDIA Developer Blog: Nemotron 3.5 Super VL Powers Specialized Agents
  2. [2] MarkTechPost: NVIDIA Nemotron 3.5 Super VL Release Details
  3. [3] VentureBeat: NVIDIA's New Open Nemotron 3.5 Super VL Benchmark Claims
  4. [4] The Decoder: NVIDIA's Nemotron 3.5 Super VL Analysis
  5. [5] Artificial Analysis: Nemotron 3.5 Super and Bolt Benchmarks
  6. [6] For.You: Jensen Huang on Nemotron 3.5 Lightning as a Hardware Strategy
  7. [7] Shattered.io: NVIDIA's $26 Billion Open-Weight Model Bet
  8. [8] CrowdStrike Press Release: Frontier Models for Cybersecurity with NVIDIA
  9. [9] HPCwire: NVIDIA Expands Nemotron Family with Super VL and Bolt
  10. [10] News.az: NVIDIA Introduces Nemotron 3.5 Lineup
  11. [11] Hugging Face: NVIDIA Nemotron 3.5 Super VL Model Card
  12. [12] NVIDIA Blog: Nemotron 3.5 Super VL Announcement

来源文章

Top 5

THE SIGNAL.

Analysts

“认为NVIDIA的开源授权推动了GPU需求,因为严肃部署仍需NVIDIA硬件。引述:“任何想充分发挥Nemotron潜力的人都最终会购买Nvidia硬件””

The Decoder (analysis)
开源发布实质上是硬件销售策略

“相信免费、开源的AI会增加运行它所需的芯片需求,从而强化NVIDIA的硬件业务。引述:“Free AI should be great for hardware. Free AI should be great for chips.””

Jensen Huang, NVIDIA CEO
将提供强大的开源模型定位为战略行为,而非慈善
The Crowd

“Meet NVIDIA Nemotron 3.5 Super VL Our new open model combines reasoning and tool use with text, image, document, and video understanding for long-running AI agents. 120B total parameters with 12B active”

@@NVIDIAAI3720

“And this one fits into 24GB of memory. Introducing Nemotron 3.5 Bolt 24GB”

@@NVIDIAAI1066

“NVIDIA's Nemotron 3.5 Super VL is now available in Perplexity for Pro and Max subscribers, and in Agent API.”

@@perplexity_ai188

“NVIDIA Nemotron Bolt 3.5 74B A9B releases Oct. 15th”

@u/CulturalKing5623694
Broadcast
Introducing NVIDIA Nemotron 3.5 Super VL

Introducing NVIDIA Nemotron 3.5 Super VL

NVIDIA Nemotron 3.5 Lightning - Built for Always-on Agents like OpenClaw and Hermes Agent

NVIDIA Nemotron 3.5 Lightning - Built for Always-on Agents like OpenClaw and Hermes Agent

Nemotron 3.5 Bolt 74B: What NVIDIA Has Documented Before Release, and What It Hasn't

Nemotron 3.5 Bolt 74B: What NVIDIA Has Documented Before Release, and What It Hasn't