帕累托改进:价格不变,单位经济效益更优
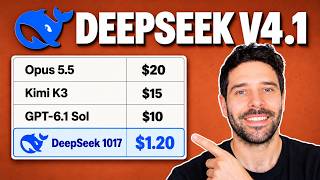
DeepSeek 于 10 月 17 日对 V4.1-Flash 进行的后训练刷新在该公司报告的全部 11 项基准测试中均优于 9 月版本,提升幅度在 2.0 至 11.1 分之间 [4]。代理式编码(agentic-coding)的分数提升最为显著:DeepSWE v1.1 从 74.2% 提升至 77.0%,超过了 Claude Opus 5(74.0%)和 GPT 5.6-Sol(73.0%)[2],而 Terminal-Bench 4.0 从 31.2 跃升至 42.3 [4]。这一切并未伴随价格上涨:DeepSeek 保留了 deepseek-flash 模型 ID 和原有的每 token 费率,1017 版本只是在完成每项任务时输出更少的 token [1][14]。正是这种 token 使用的节制,使得此次更新成为真正的帕累托改进,而非单纯的营销刷新——根据 DeepSeek 自身的数据,完成一次 DeepSWE 任务的成本从约 0.50 美元降至约 0.20 美元,同时提供一种每项任务仅 0.10 美元的精简模式,但准确率会下降 72% [3]。此次发布被描述为在现有检查点上应用了自反馈强化学习(RLSF),而非从头开始重新训练 [3]——这是一种比从零训练新基础模型更经济的方式来获取基准测试优势。