微软Decision-1模型发布
TECH

微软Decision-1模型发布

25+
Signals

战略概览

  • 01.
    微软于2026年10月9日发布了Decision-1,这是一款通过对阿里巴巴开源权重的Qwen3.5-9B模型进行后训练构建的非生成式决策评分模型,它针对一组固定的答案选项返回校准后的概率,而非生成开放式文本。
  • 02.
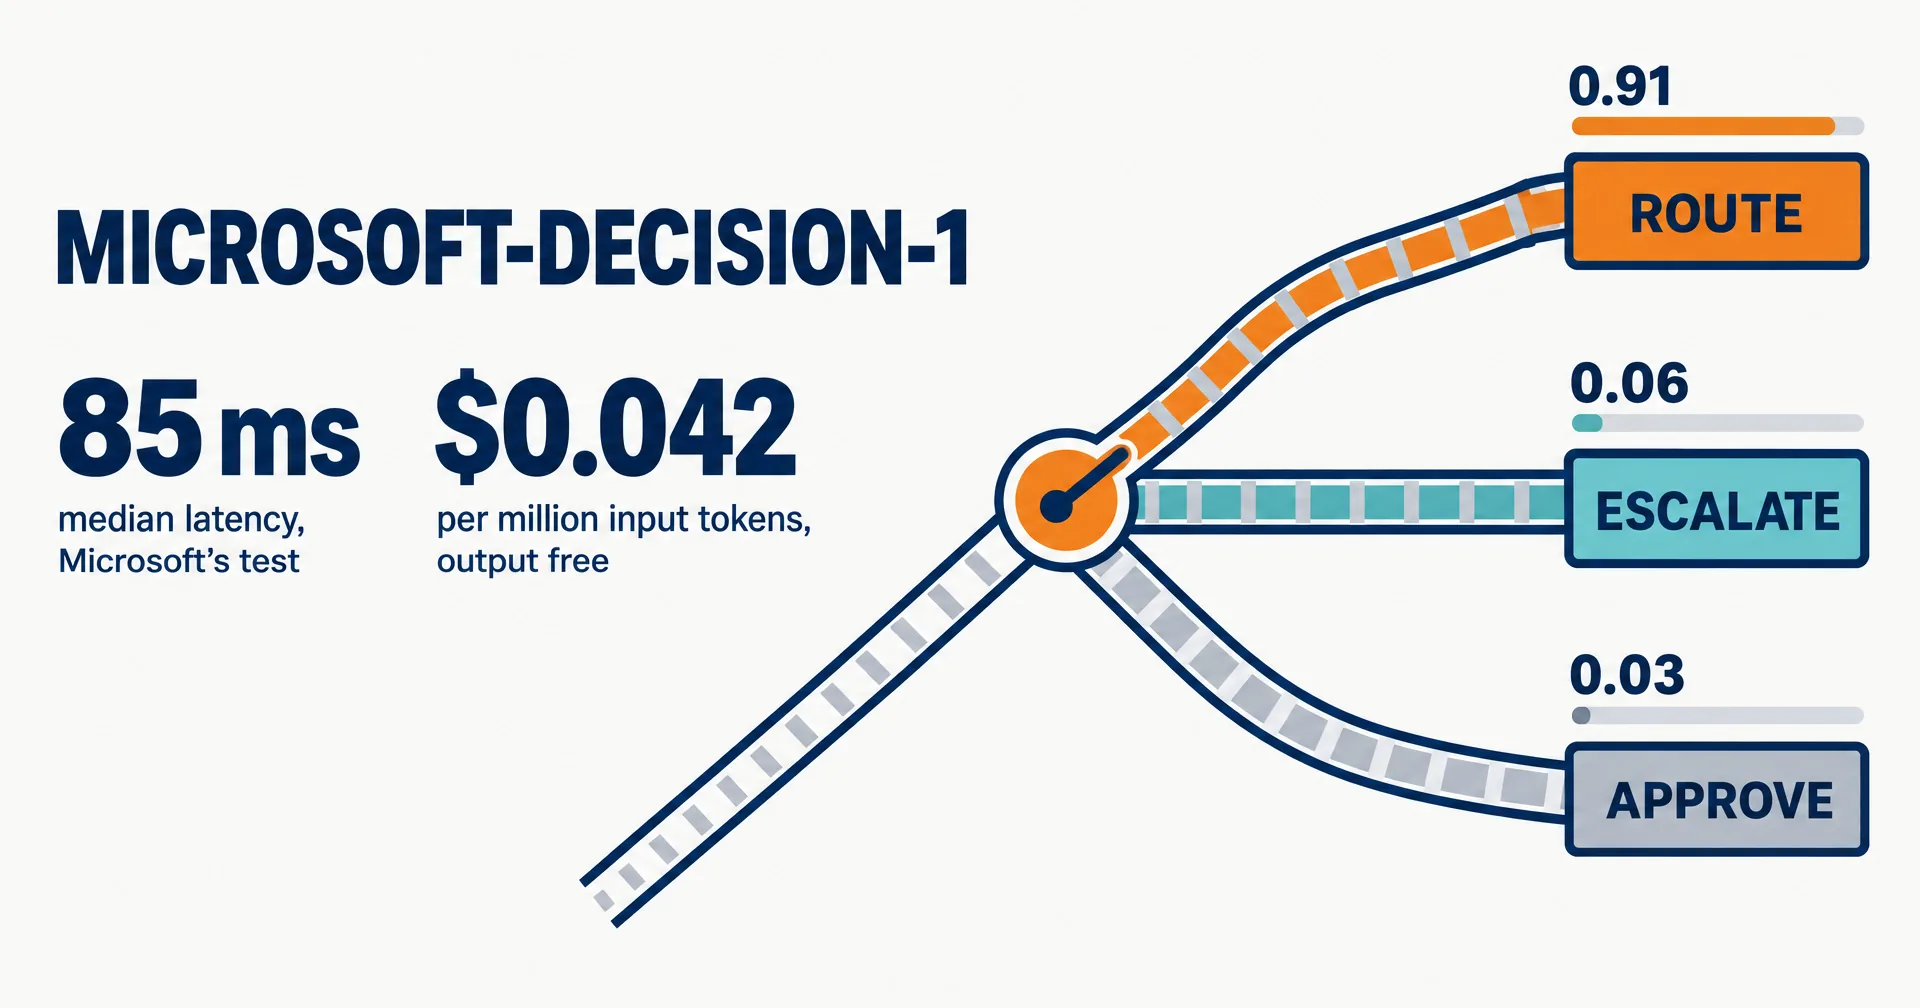
    定价为每百万输入token 0.042美元,输出token免费,目前已通过微软Foundry提供,OpenRouter接入即将上线,目标应用场景包括路由、分类、代理动作选择和安全筛查。
  • 03.
    微软声称在涵盖约15万道保密问题的36项基准测试中,Decision-1准确率最高,且P50延迟在对比模型中最低,内部Xbox研究团队和Copilot团队也报告了早期部署带来的显著速度和成本提升。
  • 04.
    独立分析质疑微软的核心速度主张,指出其将微软自测的原始数据与经过公式调整的竞品数据进行对比,实际原始计时优势更接近1.4倍,而非宣传的4.5倍。

深度分析

一个真正的新模型类别,还是仅仅是一个单token的LLM?

Nadella亲自发布了Decision-1,将其定位为在延迟和质量方面超越通用LLM和其他决策模型[1]。但更尖锐的反应并非来自高管的表述——而是来自工程师们对“决策模型”本身定义的拆解。在r/singularity的发布帖中,争论分为两派:一派认为Decision-1“字面意义上”不过是将标准LLM的输出截断为单个token并限制logprobs;另一派则反驳称,专为决策评分设计的模型完全跳过了自回归推理的开销,因此在结构上对窄域选择任务更高效,而不仅仅是约束方式不同。另一条质疑线索则质疑其市场定位本身,指出Copilot已经封装了第三方聊天模型,认为Decision-1更像是一个Azure生态系统的企业级布局,而非前沿聊天模型的竞争对手。

独立评论普遍认为,类别标签的重要性不如底层架构信号。“Decision-1的意义在于挑战了通用LLM的默认使用,而非因为CEO发布了它,”Sophie Larsen[2]指出,并警告称微软的内部基准数据仍需独立验证。Reddit上的另一条讨论甚至追溯到LLM之前的时代,评论者指出,分类器式决策模型早于生成式AI时代——BERT时代的分类器就做过类似的事——用现代工具构建这类模型“极其简单”,这引发了一个问题:Decision-1的真正贡献是创造了一个新原语,还是仅仅对旧有模型进行了良好封装和定价?
基准测试实际上并未解决竞争格局

微软自身与TypeSafe的Jev对比表并未显示压倒性胜利。Decision-1报告了更高的准确率(83.5% vs 82.3%)和更低的中位延迟(85ms vs 240ms),但Jev在校准性上领先(93.7 vs 92.2)[3],这意味着两个模型在不同指标上各有胜负,而非一方全面胜出。

“比亚军快4.5倍”的宣传主张争议更大。独立分析发现,该对比将微软自测的85ms Foundry数据与一个通过公式推导出的380ms JevBench“调整后”数值进行比较,而JevBench自身说明指出该调整是“一种假设,而非硬件归一化”。在真正公平的原始计时基础上,差距缩小至约1.4倍(85ms vs 116ms),而非4.5倍[4]。r/machinelearningnews上的一篇帖子并行指出,H2O.ai的模型卡据称列出了H2O-Lightning-4B的原始中位延迟仅为29ms,远低于微软图表中引用的210ms。r/singularity上的另一条讨论则针对Jev提出特定异议:评论者指出Jev的真正优势在于批量吞吐量(约150ms内完成255次决策),而非单次请求延迟,因此仅以单次决策延迟进行对比可能本身具有误导性。综合来看,微软发布材料中的几乎每一项具体数据都从不同角度遭到了方法论挑战。

并非所有独立检验都对微软不利。一位开发者在X平台上进行了一次非正式的直接对比,让Decision-1与OpenAI的决策评分API进行反应速度游戏,报告称Decision-1响应速度快约3.5倍,并比OpenAI模型多通过了更多关卡。这虽非正式测试,也未发布为基准,但与微软内部数据不同,它来自公司外部——这提醒我们,争议焦点在于方法论和表述方式,而非Decision-1在绝对意义上是否快速。

微软的决策层建立在一个中国开源权重模型之上

Decision-1并非基于微软或OpenAI的基础模型,而是基于阿里巴巴开源权重的Qwen3.5-9B模型进行后训练而来[5]。这是一种务实的押注:对于窄域决策评分任务,基础模型的来源不如速度和价格重要,通过后训练现有开源权重模型,微软得以快速推出一款定价明确、经过基准测试的产品,而非从零训练一个基础模型。一则科技解释视频指出,尽管运行在第三方中国基础模型之上,Decision-1的输入价格实际上与TypeSafe的Jev持平,凸显了无论产品底层架构如何,决策评分定价在各厂商间已趋于商品化。

这一选择也招致批评。r/machinelearningnews上一位评论者反对微软将开源权重的中国模型微调后用于商业用途,却未将微调后的权重回馈社区,认为这颠倒了通常的开源交换原则。另一场讨论则挑战了更广泛的决策模型融资图景:一位评论者称某竞争对手约8亿美元的估值“荒谬”,认为一旦该类别成熟,微软等巨头将轻松碾压小型玩家;另一评论者则反驳——这场实时争论无论结果如何,都凸显了谁将真正赢得这一细分市场仍悬而未决。

真正的赌注在于规模:将低成本决策从前沿LLM中分流

微软的定价——每百万输入token 0.042美元,输出免费——被分析师明确解读为对成本已成为开发者构建代理式AI流水线时主导因素的回应,在此类流水线中,单个任务可能产生数十个离散的路由或分类子决策[6]。其战略逻辑是在Azure、Fabric、Foundry和Copilot中掌控AI堆栈中的独立“决策层”,并将其与通用LLM推理分开变现,而非争夺相同的聊天补全收入。

一位Reddit评论者直接描绘了这一模式的实际应用:将决策模型与前沿LLM配对,让LLM将简单的“是/否”或分类子决策卸载给更便宜的模型,这种替代在大规模下“积少成多”实现节省。微软自身引用的内部部署案例正是这一模式的早期验证点——Xbox研究团队和Copilot团队均报告在生产工作负载上实现了显著的速度和成本降低[1]——尽管这些数据与发布材料其余部分一样,均来自微软自身,尚未有独立基准发布以证实。

历史背景

微软在Microsoft Foundry中宣布并发布了Microsoft-Decision-1,OpenRouter的接入将紧随其后。

关键关系图

关键玩家
主题

微软Decision-1模型发布

MI

Microsoft

Decision-1的开发者和发布者,将其定位为Azure、Fabric、Foundry和Copilot中代理式AI堆栈的决策层,定价策略旨在从高频率、低价值的决策调用中独立于通用LLM使用进行变现。

AL

Alibaba (Qwen)

提供了微软用于后训练构建Decision-1的开源权重Qwen3.5-9B基础模型,而非使用微软或OpenAI的基础模型。

TY

TypeSafe (Jev)

直接竞争对手,其决策模型在校准性上(93.7 vs 92.2)优于Decision-1,尽管微软声称在准确率和延迟上更高,这意味着竞争结果因指标而异,而非明确决出胜负。

SA

Satya Nadella (Microsoft CEO)

亲自发布并背书了该产品,公开宣称Decision-1在延迟和质量上超越通用LLM和竞品决策模型,为后续被外部分析师质疑的主张赋予了高管权威。

OP

OpenRouter

第三方模型市场,将Decision-1的分发扩展到Azure生态系统之外,与Foundry的即时发布并列标注为‘即将上线’。

事实来源

6 条引用
  1. [1] Microsoft Launches Decision-1 Model in Foundry
  2. [2] Microsoft Decision-1 Model Arrives, But Nadella's Endorsement Is Not the Main Story
  3. [3] Microsoft Decision-1
  4. [4] Microsoft Decision-1: 4.5x Faster Than Runner-Up? Raw Timing Gives 1.4x
  5. [5] Microsoft-Decision-1: Decision Model in Foundry
  6. [6] Microsoft Launches Decision-1 at $0.042 Per Million Tokens

来源文章

Top 5

THE SIGNAL.

Analysts

“认为微软‘比亚军快4.5倍’的说法混淆了微软自测的原始数据与经过公式调整的竞品数据,实际原始计时领先仅约1.4倍。”

P.K. Sharma
独立AI分析师,pk-sharma.com简报

“认为Decision-1的真正意义在于架构上摆脱了将所有任务路由通过通用LLM的模式,而非纳德拉的个人背书,并警告微软的内部基准仍需独立验证。”

Sophie Larsen
作者,remio.ai

“将Decision-1定位为在结构化决策任务的延迟和质量上超越通用LLM和竞品决策模型。”

Satya Nadella
微软CEO
The Crowd

“Introducing Microsoft-Decision-1, our new model for fast decision-making. It delivers top performance on structured decision tasks, outperforming both LLMs and other decision models in latency and quality. We're already testing it across Microsoft for everything from incident...”

@@satyanadella9556

“Microsoft-Decision-1 is live on OpenRouter. Microsoft's numbers: highest accuracy across 36 blind benchmarks (~150K questions), 4.5x faster than the runner-up, 35x faster than GPT-6 Sol, and decisions flip on just 1.3% of perturbed inputs. Post-trained from Qwen3.5-9B. $0.042/M”

@@OpenRouter524

“OpenAI Decision crushed by @Microsoft-Decision-1 at Space Invaders. Decision-1 decided 3.5x faster so it scored 3,320 and cleared 4 waves while OpenAI's decision API scored 1,300 taking over 300ms per decision on average. Run decision models ->”

@@atomic_chat_hq225

“Introducing Microsoft-Decision-1, our model for fast decision-making”

@u/Greedyanda527
Broadcast
Microsoft's New Decision Model: A Fresh AI Catalyst and the $537 Test | Oct 9

Microsoft's New Decision Model: A Fresh AI Catalyst and the $537 Test | Oct 9

Microsoft Decision-1: Same Price as Jev, Built on Qwen

Microsoft Decision-1: Same Price as Jev, Built on Qwen

Microsoft Just Beat GPT-6 With a Chinese Model

Microsoft Just Beat GPT-6 With a Chinese Model