The Research Desk.

The most upvoted and starred AI research crossing the community today.

Last Brew Time: Oct 29, 2026, 12:27 PM PT

X.com Research Buzz

Evidence for the representation of non-hierarchical structures in language
X.com
7576

Evidence for the representation of non-hierarchical structures in language

Morten H. Christiansen, Yngwie Nielsen

Cornell University, Aarhus University

NLP
STAIR (STructure Aware Information Retriever): A novel dataset and LLM based retriever for document structure augmentation
X.com
7092

STAIR (STructure Aware Information Retriever): A novel dataset and LLM based retriever for document structure augmentation

Vineet Kumar, Meghanadh Pulivarthi, vishwajeet kumar, Jaydeep Sen, Riyaz Ahmad Bhat, Sachindra Joshi

IBM, Amazon
AlphaXiv Trending

Reinforcement Learning
Evolving Agent Teams
AlphaXiv
74

Evolving Agent Teams

1k, Views

Affiliation: University of California, Berkeley, University of California, Berkeley

NLP
AlphaXiv
38

How to Train a One-Step Language Model Without a Teacher

1k, Views

Reasoning
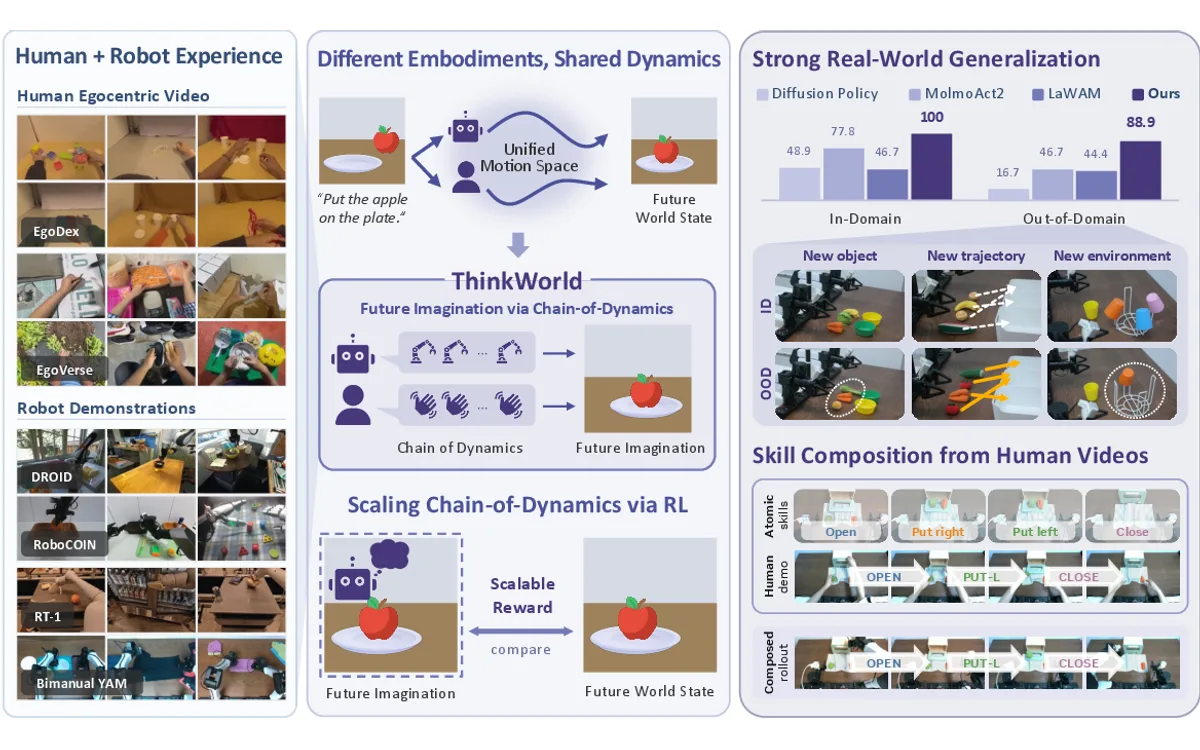
ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
AlphaXiv
36

ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning

Views

Affiliation: NVIDIA, Affiliation: NVIDIA Affiliation: KAIST, NVIDIA
Reinforcement Learning
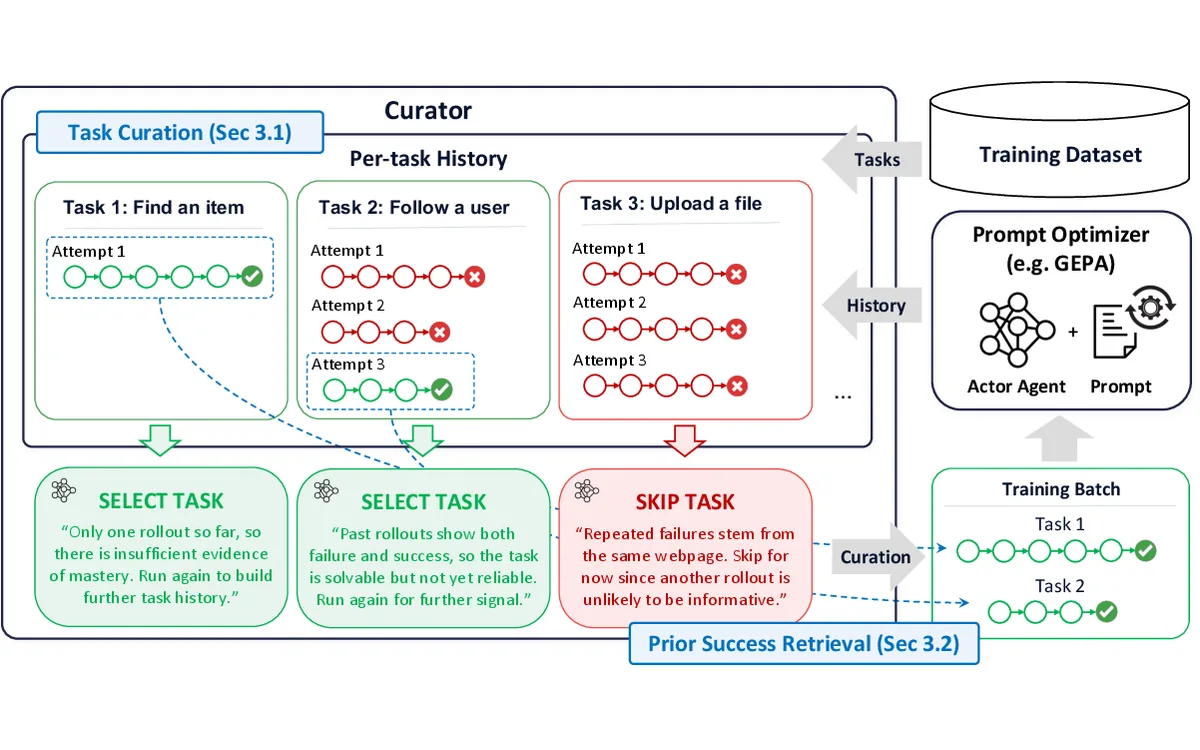
GEPA-Curator: Curated Learning for Self Improving Agents
AlphaXiv
20

GEPA-Curator: Curated Learning for Self Improving Agents

Views

NLP
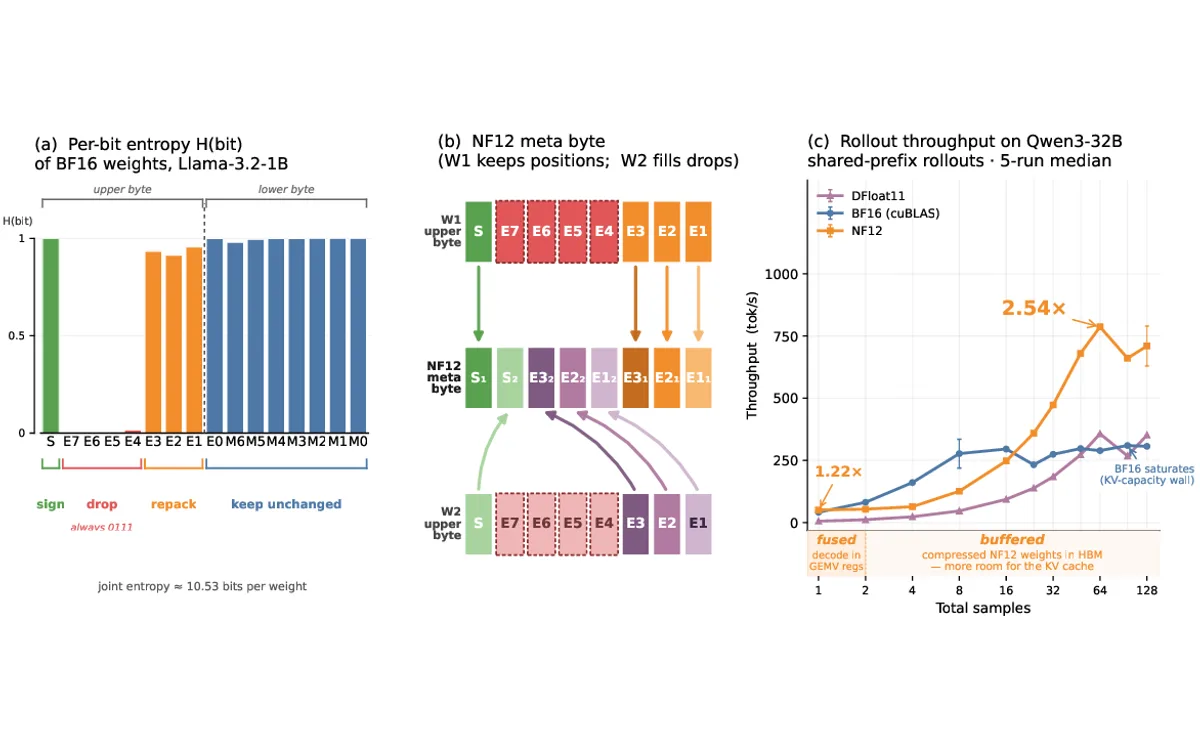
NyoomFloat12: Accelerating LLM Inference via Lossless 12-Bit Weight Compression
AlphaXiv
11

NyoomFloat12: Accelerating LLM Inference via Lossless 12-Bit Weight Compression

Views

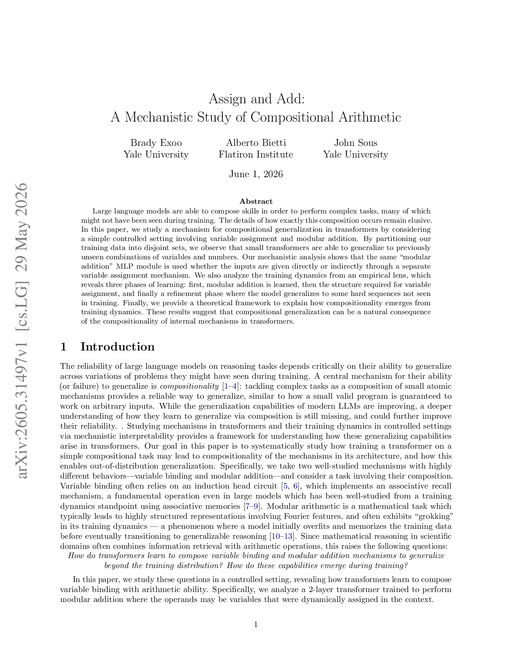
Assign and Add: A Mechanistic Study of Compositional Arithmetic
AlphaXiv
3

Assign and Add: A Mechanistic Study of Compositional Arithmetic

Affiliation: Yale University, Affiliation: Flatiron Institute, Yale University, Flatiron Institute

HuggingFace Daily Papers

Reinforcement Learning
RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents
HuggingFace
15

RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents

Yunqi Liu, Peiyu Wang, Bingli Wang, Leo Luo, Xuanwu Song

IQuest

Reinforcement Learning
TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents
HuggingFace
9

TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents

Krishanu Adhikary, Prashant Devadiga

National Payments Corporation of India

NLP
Amortizing Sequential Experimental Design in Reasoning LLMs
HuggingFace
4

Amortizing Sequential Experimental Design in Reasoning LLMs

Anita Kriz, Antonin Berthon, Nicolás Astorga, Mihaela van der Schaar

University of Cambridge

NLP
LongZero: Enhancing Long-Context Reasoning in LLMs from Zero Data
HuggingFace
3

LongZero: Enhancing Long-Context Reasoning in LLMs from Zero Data

Zhennan Wan, Jianfei Chen

Tsinghua University

Robotics
Evaluating DeepSeek V4.1 Flash-1017 for loss of control and harmful manipulation risks
HuggingFace
2

Evaluating DeepSeek V4.1 Flash-1017 for loss of control and harmful manipulation risks

Yao Huang, Zhiyuan Zeng, Yu Wang, Zhitong Zhu, Dingcheng Duan

Fangcun AI

Reinforcement Learning
CausGround: Causal Interaction Grounding for Adaptive Embodied Planning
HuggingFace
2

CausGround: Causal Interaction Grounding for Adaptive Embodied Planning

Yijun Shen, Diqi He, Jinbang Guo, Wanyue Zhang, Jiaming Mi