The Research Desk.

The most upvoted and starred AI research crossing the community today.

Last Brew Time: Oct 2, 2026, 11:25 AM PT

X.com Research Buzz

Sycophantic Chatbots Cause Delusional Spiraling, Even in Ideal Bayesians
X.com
15453

Sycophantic Chatbots Cause Delusional Spiraling, Even in Ideal Bayesians

Kartik Chandra, Max Kleiman-Weiner, Jonathan Ragan-Kelley, Joshua B. Tenenbaum

MIT CSAIL, University of Washington, Seattle, MIT Department of Brain & Cognitive Sciences

NLP
The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It
X.com
9491

The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It

Cameron Berg, Valen Tagliabue

Financing the AI Buildout
X.com
8324

Financing the AI Buildout

Stijn Van Nieuwerburgh

Columbia Business School

AlphaXiv Trending

NLP
Tokenization: A Survey for Modern NLP
AlphaXiv
158

Tokenization: A Survey for Modern NLP

Invent a Dataset: Measuring Dataset Generation Abilities with Zero Seed Data
AlphaXiv
70

Invent a Dataset: Measuring Dataset Generation Abilities with Zero Seed Data

4k, views

Retrieval
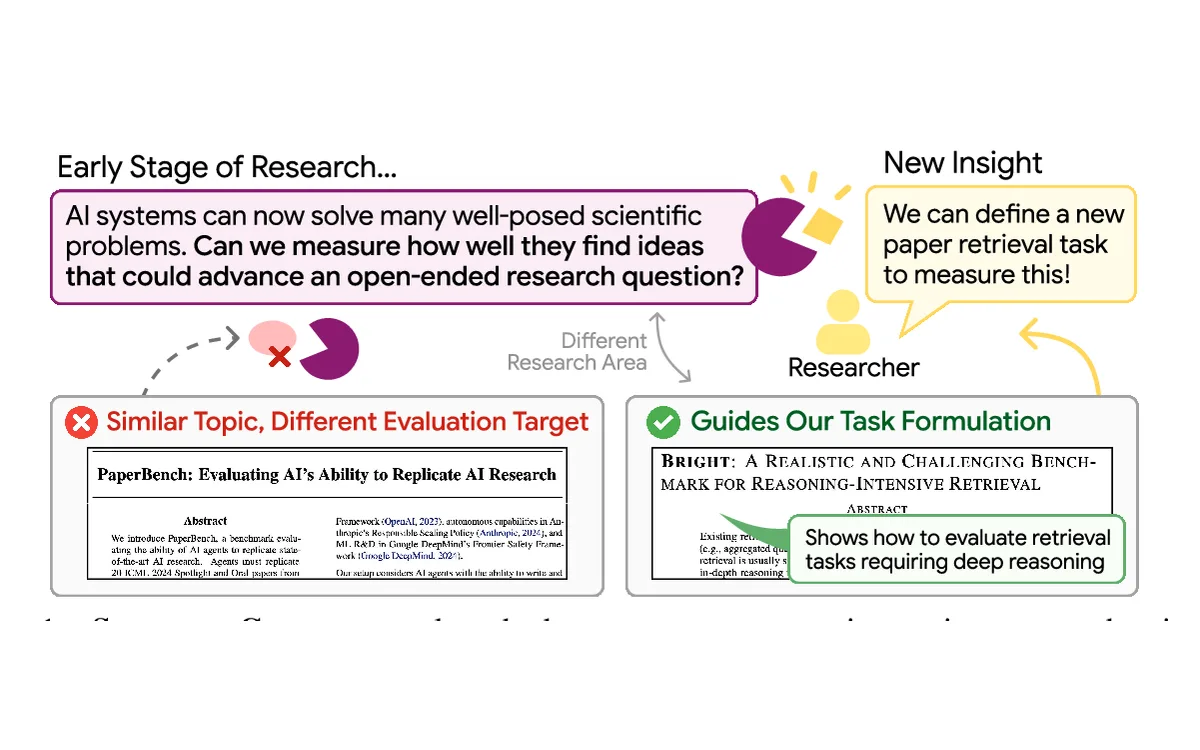
ScholarCatalyst: A Benchmark for Retrieving Papers That Inspire New Research
AlphaXiv
54

ScholarCatalyst: A Benchmark for Retrieving Papers That Inspire New Research

1k, views

Affiliation: Stanford University Seoul National University University of Washington, Affiliation: Carnegie Mellon University Allen Institute for AI MIT, Retrieving Papers that Inspire New Research, Stanford University Seoul National University University of Washington, Carnegie Mellon University Allen Institute for AI MIT

NLP
Looped Diffusion Transformer
AlphaXiv
47

Looped Diffusion Transformer

SenseTime Research, LeapLab, Tsinghua University

Machine Learning
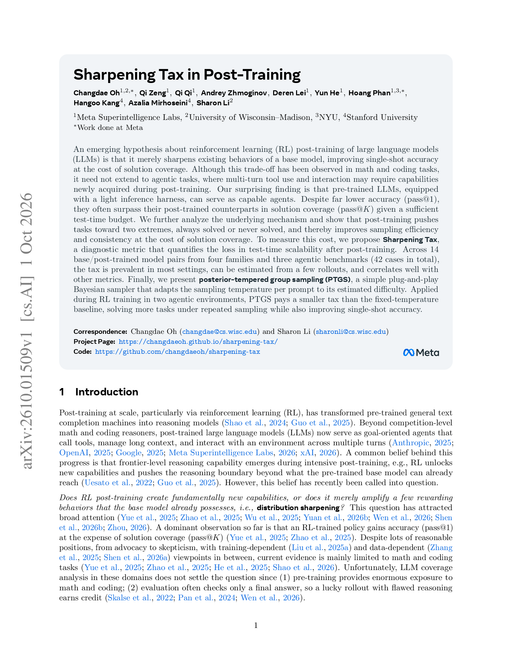
Sharpening Tax in Post-Training
AlphaXiv
30

Sharpening Tax in Post-Training

views

Affiliation: Meta Superintelligence Labs, Affiliation: University of Wisconsin–Madison, Affiliation: Stanford University, Meta Superintelligence Labs, University of Wisconsin–Madison

Reinforcement Learning
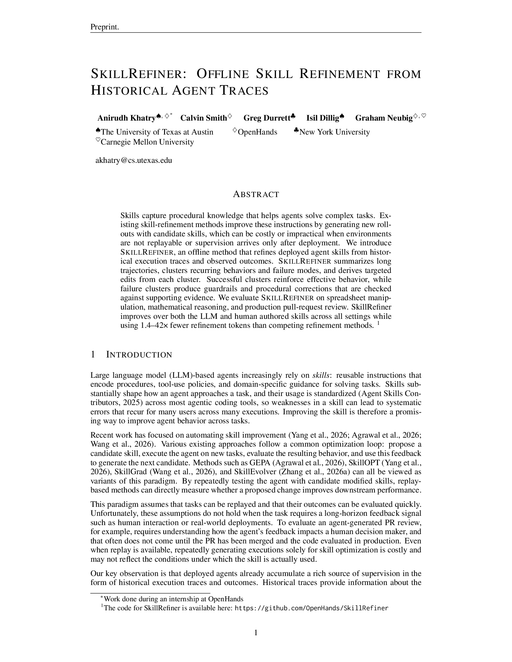
SkillRefiner: Offline Skill Refinement from Historical Agent Traces
AlphaXiv
29

SkillRefiner: Offline Skill Refinement from Historical Agent Traces

views

HuggingFace Daily Papers

Reinforcement Learning
On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
HuggingFace
16

On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics

Julianna Piskorz, Antonin Berthon, Mihaela van der Schaar

University of Cambridge

Reasoning
OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories
HuggingFace
4

OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories

Anqi Li, Zhixuan Ge, Yixuan Duan, Jiarong Qian, Chi-Yu Chen

Retrieval
ScholarCatalyst: A Benchmark for Retrieving Papers That Inspire New Research
HuggingFace
3

ScholarCatalyst: A Benchmark for Retrieving Papers That Inspire New Research

Sohyeon Kim, Yoonho Lee, Bo Liu, Dayoon Ko, Rulin Shao

NLP
X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
HuggingFace
2

X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization

Sitao Cheng, Xunjian Yin, Zhiyuan Sun, Yuxuan Li, Ruiwen Zhou

University of Waterloo

Computer Vision
Honeycomb: Constant-Size Scene Memory Representation for Video World Models
HuggingFace
1

Honeycomb: Constant-Size Scene Memory Representation for Video World Models

Jack Wei Lun Shi, Kaichen Zhou, Haoyu Chen, Yufeng Weng, Keane Ong

NLP
Keyword Harnesses Fail Open: A Cheap Diagnostic Ladder for Tool-Use Claims in Small Language Models
HuggingFace
0

Keyword Harnesses Fail Open: A Cheap Diagnostic Ladder for Tool-Use Claims in Small Language Models

Juan S. Santillana