The Research Desk.

The most upvoted and starred AI research crossing the community today.

Last Brew Time: Sep 16, 2026, 11:40 AM PT

X.com Research Buzz

Reasoning
Theory Is All You Need: AI, Human Cognition, and Causal Reasoning
X.com
6551

Theory Is All You Need: AI, Human Cognition, and Causal Reasoning

Teppo Felin, Matthias Holweg

University of Oxford

Bounded Ratios for Lorentzian Polynomials
X.com
4013

Bounded Ratios for Lorentzian Polynomials

Aayush Bathija, Prince Rohatgi, Daniel Soskin

UCLA Math Circle
AlphaXiv Trending

NLP
FlashREINFORCE: Critic-Free Single-Rollout Asynchronous RL for Agentic Language Models
AlphaXiv
99

FlashREINFORCE: Critic-Free Single-Rollout Asynchronous RL for Agentic Language Models

Dream-RSI: Recursive Self-Improvement through Evolving Worlds
AlphaXiv
58

Dream-RSI: Recursive Self-Improvement through Evolving Worlds

Affiliation: University of Maryland, College Park, Affiliation: Google Deepmind, Affiliation: University of Virginia, University of Maryland, College Park, Google Deepmind
Reinforcement Learning
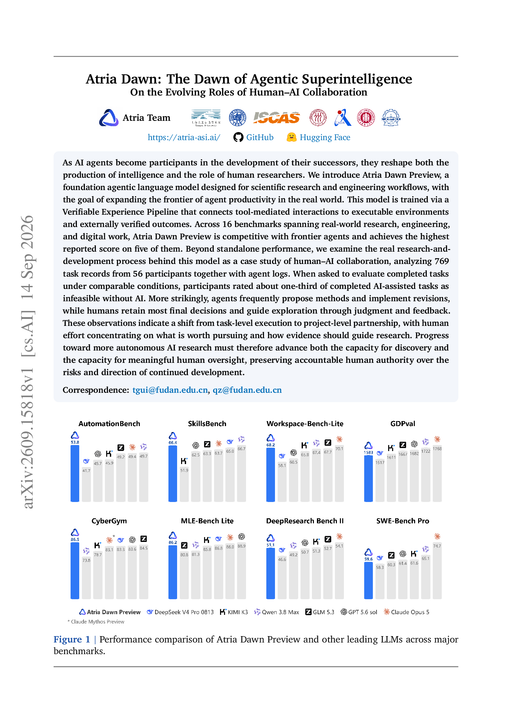
Atria Dawn: The Dawn of Agentic Superintelligence
AlphaXiv
35

Atria Dawn: The Dawn of Agentic Superintelligence

NLP
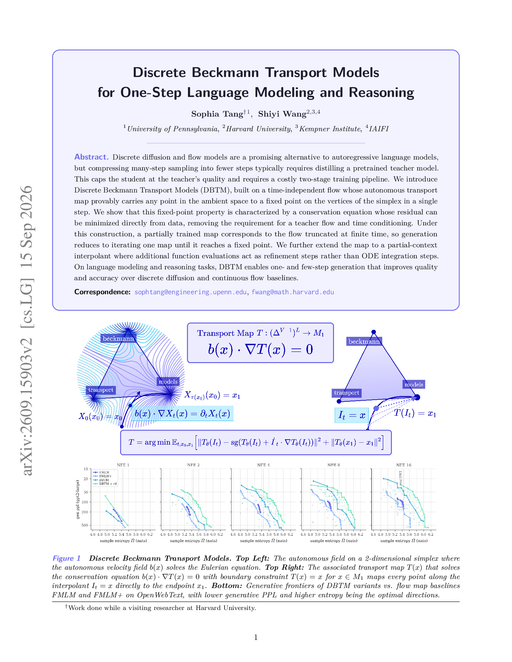
Discrete Beckmann Transport Models for One-Step Language Modeling and Reasoning
AlphaXiv
32

Discrete Beckmann Transport Models for One-Step Language Modeling and Reasoning

University of Pennsylvania, Harvard University, Kempner Institute
Reinforcement Learning
Forty Shades of Blue: Quality-Diversity Alignment via Mode-Conditioned Reinforcement Learning
AlphaXiv
19

Forty Shades of Blue: Quality-Diversity Alignment via Mode-Conditioned Reinforcement Learning

University of Washington, Stanford University

HuggingFace Daily Papers

Computer Vision
FLAT: Resampling Image and Text into 1D Flexible-Length Aligned Transmodal Tokens for Retrieval and Generation
HuggingFace
12

FLAT: Resampling Image and Text into 1D Flexible-Length Aligned Transmodal Tokens for Retrieval and Generation

Guangyu Sun, Shlok Kumar Mishra, Wentao Bao, Robert Zhenheng Yang, Xiao Wang

Meta

Reinforcement Learning
ImpossibleRubrics: Stress-Testing Generated Rubrics as Reward Signals
HuggingFace
2

ImpossibleRubrics: Stress-Testing Generated Rubrics as Reward Signals

Bowen Qin, Yi Xie, Yesheng Liu, Xi Yang

Convergent Emergence of In-Context Learning Across Modalities
HuggingFace
2

Convergent Emergence of In-Context Learning Across Modalities

Nathan Breslow, Seungwook Han, Daniel Hyunsoo Lee, Aayush Mishra, Anqi Liu

Center for Language and Speech Processing @ JHU

Maelic
RelateAnything: Real-Time Open-Vocabulary Relation Prediction From Any Inputs
HuggingFace
2

RelateAnything: Real-Time Open-Vocabulary Relation Prediction From Any Inputs

Maëlic Neau

Reinforcement Learning
Generalized Agent Iteration: One Formal Framework for Iterative Policy Improvement and Recursive Self-Improvement
HuggingFace
2

Generalized Agent Iteration: One Formal Framework for Iterative Policy Improvement and Recursive Self-Improvement

Hongyao Tang, Yi Ma, Pengyi Li, Yifu Yuan

Computer Vision
OmniHarness: Harnessing Generalizable Visual Generation via Symbolic Policy Learning
HuggingFace
1

OmniHarness: Harnessing Generalizable Visual Generation via Symbolic Policy Learning

Xu Xu, Jinxiu Liu, Zhangbo Qiao, Jiaxing Lu, Xiangyu Zhang