The Research Desk.

The most upvoted and starred AI research crossing the community today.

Last Brew Time: Oct 13, 2026, 11:12 AM PT

AlphaXiv Trending

RSI-Anything: Unlocking Recursive Self-Improvement with World Models
AlphaXiv
60

RSI-Anything: Unlocking Recursive Self-Improvement with World Models

Views

NLP
Thinking Inertia: LLMs Keep Thinking When Told Not To
AlphaXiv
30

Thinking Inertia: LLMs Keep Thinking When Told Not To

Views

Machine Learning
Correction Training for Diffusion Models
AlphaXiv
19

Correction Training for Diffusion Models

Views

Reinforcement Learning
Scaling Empowered Agents
AlphaXiv
18

Scaling Empowered Agents

Department of Physics, Princeton University, Department of Computer Science, Department of Mathematics
NLP
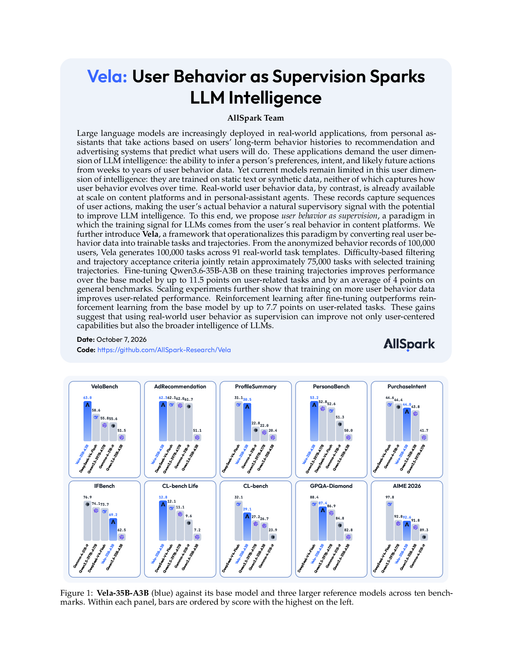
Vela: User Behavior as Supervision Sparks LLM Intelligence
AlphaXiv
10

Vela: User Behavior as Supervision Sparks LLM Intelligence

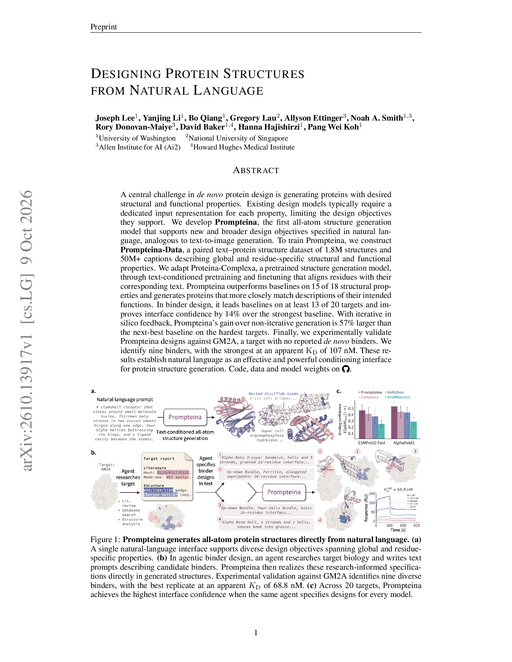
Designing Protein Structures from Natural Language
AlphaXiv
9

Designing Protein Structures from Natural Language

Views

Affiliation: University of Washington, Affiliation: National University of Singapore, Affiliation: Allen Institute for AI (Ai2, Affiliation: Howard Hughes Medical Institute, Affiliation: University of Washington Affiliation: Allen Institute for AI (Ai2

HuggingFace Daily Papers

Reinforcement Learning
CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation
HuggingFace
20

CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation

Hanwen Lu, Jun He, Mingjia Yang, Hao Wei, Jinhao Huang

Sun Yat-Sen University

NLP
Initialization Improves LLM-Driven Discovery
HuggingFace
4

Initialization Improves LLM-Driven Discovery

Mansi Sakarvadia, Marco Ciccone, Colin Raffel

Vector Institute

Reinforcement Learning
Branching On-Policy Distillation
HuggingFace
4

Branching On-Policy Distillation

Dongyang Chen, Shudong Liu, Shubo Li, Duoxun Tang, Jinwei Liang

BranchOPD

Reinforcement Learning
Prospective Hindsight: Self-Calibrating Reinforcement Learning via Prediction-Reality Gaps
HuggingFace
2

Prospective Hindsight: Self-Calibrating Reinforcement Learning via Prediction-Reality Gaps

Jiaxin Zhang, Xiangyu Peng, Qinglin Chen, Yu Li, Hiroaki Hayashi

Salesforce AI Research

NLP
Evaluating LLM Creativity through Long-Tail Performance
HuggingFace
2

Evaluating LLM Creativity through Long-Tail Performance

Yichen Wang, Tenghao Huang, Vishakh Padmakumar, Mina Lee

University of Chicago

Reasoning
Same Output, Different Gold: Measuring How Reference Choice Moves a Multilingual Benchmark Score
HuggingFace
2

Same Output, Different Gold: Measuring How Reference Choice Moves a Multilingual Benchmark Score

Parth Kulshreshtha, Shivali Dalmia, Abhishek Mukherji

Centific Applied AI Research