The Research Desk.

The most upvoted and starred AI research crossing the community today.

Last Brew Time: Oct 14, 2026, 12:19 PM PT

X.com Research Buzz

Navier–Stokes Lost in Translation: Why Lean Verification of AI Autoformalisation Does Not Guarantee Correct Natural Language Proofs
X.com
6521

Navier–Stokes Lost in Translation: Why Lean Verification of AI Autoformalisation Does Not Guarantee Correct Natural Language Proofs

Anders Moen

University of Cambridge

AlphaXiv Trending

Machine Learning
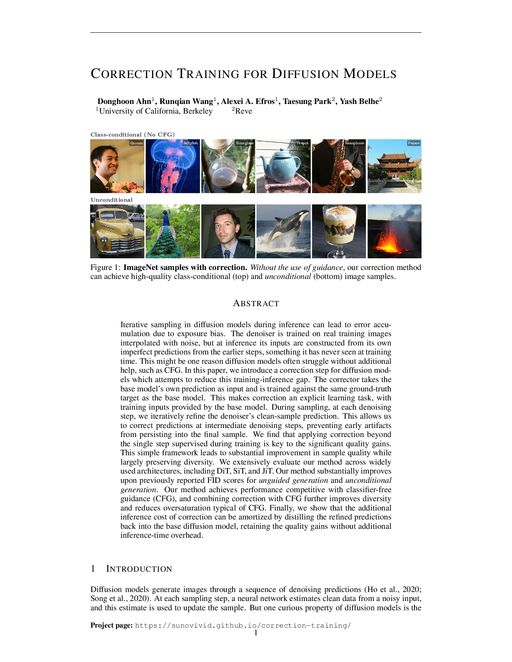
Correction Training for Diffusion Models
AlphaXiv
73

Correction Training for Diffusion Models

Views

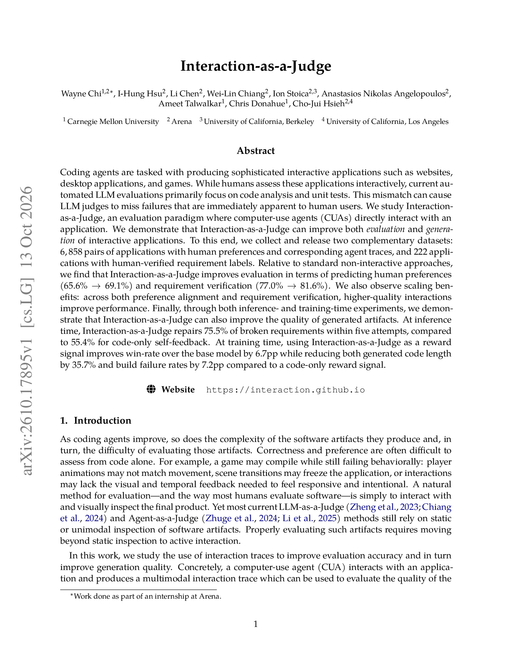
Interaction-as-a-Judge
AlphaXiv
21

Interaction-as-a-Judge

NLP
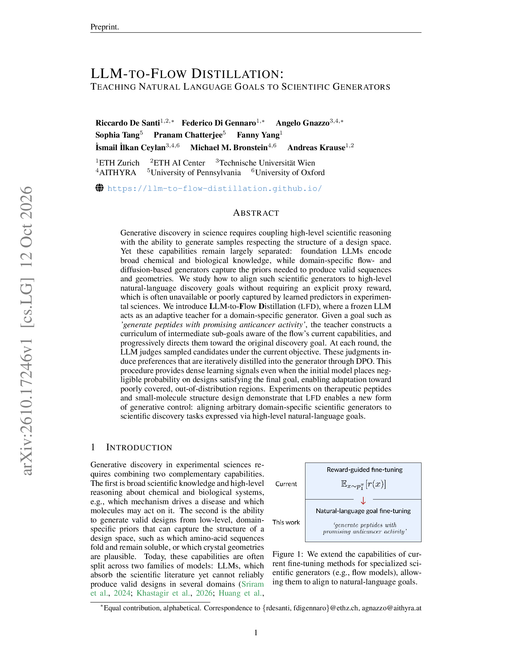
LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators
AlphaXiv
21

LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators

ETH AI Center, University of Pennsylvania, University of Oxford
Reinforcement Learning
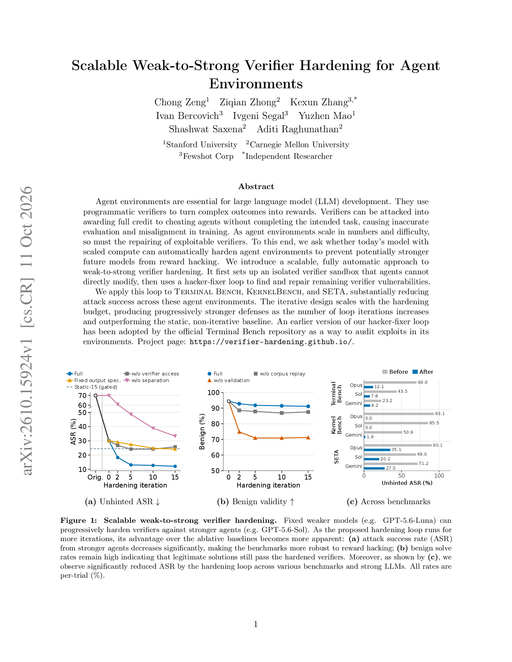
Scalable Weak-to-Strong Verifier Hardening for Agent Environments
AlphaXiv
20

Scalable Weak-to-Strong Verifier Hardening for Agent Environments

Affiliation: Stanford University, Affiliation: Carnegie Mellon University, Stanford University, Carnegie Mellon University
Multimodal
Scaling Laws for Multimodal Data Mixtures
AlphaXiv
18

Scaling Laws for Multimodal Data Mixtures

Affiliation: MILA - Quebec AI Institute, McGill University, Affiliation: University of Washington, MILA - Quebec AI Institute, McGill University, University of Washington
Computer Vision
VideoJev: System One Model for Video Understanding and Interaction
AlphaXiv
17

VideoJev: System One Model for Video Understanding and Interaction

Views

HuggingFace Daily Papers

Pristine Models
HuggingFace
7

Pristine Models

Anirudh Sundara Rajan, Krishna Kumar Singh, Richard Zhang, Yong Jae Lee

University of Wisconsin - Madison

Reinforcement Learning
Beyond the Verdict: Agentic Code Judging with Verifiable Feedback
HuggingFace
2

Beyond the Verdict: Agentic Code Judging with Verifiable Feedback

Zheye Deng, Sha Li, Changlong Yu, Xin Liu, Qin Lu

Reinforcement Learning
Scaling Verifiable Environments for Long-horizon Work Agents
HuggingFace
1

Scaling Verifiable Environments for Long-horizon Work Agents

Jiazheng Zhang, Long Ma, Yunxian Yang, Zhiheng Xi, Zhikai Lei

Tencent Hunyuan

Privacy-Preserving Intent Fulfilment and Assurance for 6G RAN
HuggingFace
0

Privacy-Preserving Intent Fulfilment and Assurance for 6G RAN

Joss Armstrong

Ericsson AB

NLP
Image Tokenizers Should Be Trained Between Images
HuggingFace
0

Image Tokenizers Should Be Trained Between Images

Ole Beißwenger, Jan-Niklas Dihlmann, Hendrik Lensch

CG Tübingen

NLP
Words to World: Benchmarking LLMs in Interactive Physical Environments
HuggingFace
0

Words to World: Benchmarking LLMs in Interactive Physical Environments

Xinnan Dai, Kaiqi Yang, Yaxin Li, Cheng Luo, Wanli Li

AI Research Papers — October 14, 2026 Edition | Agentic Brew