The Research Desk.

The most upvoted and starred AI research crossing the community today.

Last Brew Time: Oct 7, 2026, 11:18 AM PT

X.com Research Buzz

Sycophantic Chatbots Cause Delusional Spiraling, Even in Ideal Bayesians
X.com
15506

Sycophantic Chatbots Cause Delusional Spiraling, Even in Ideal Bayesians

Kartik Chandra, Max Kleiman-Weiner, Jonathan Ragan-Kelley, Joshua B. Tenenbaum

MIT CSAIL, University of Washington, Seattle, MIT Department of Brain & Cognitive Sciences

Speech Audio
An Industrial-Strength Audio Search Algorithm
X.com
12820

An Industrial-Strength Audio Search Algorithm

Avery Li-Chun Wang

Shazam Entertainment, Ltd.

NLP
The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It
X.com
9530

The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It

Financing the AI Buildout
X.com
8980

Financing the AI Buildout

Stijn Van Nieuwerburgh

Columbia Business School

AlphaXiv Trending

Truly Subquadratic 3SUM and Truly Subcubic APSP via Triangles in Sparse Lopsided Graphs
AlphaXiv
81

Truly Subquadratic 3SUM and Truly Subcubic APSP via Triangles in Sparse Lopsided Graphs

1k, views

Affiliation: Columbia University, Columbia University

Computer Vision
H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning
AlphaXiv
72

H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning

views

Affiliation: Brown University, Affiliation: Advanced Machine Intelligence Affiliation: Brown University, Brown University

Machine Learning
Base Models Can Reason By Taking a Cue From Training Data
AlphaXiv
61

Base Models Can Reason By Taking a Cue From Training Data

views

Efficiency
Optimal and Efficient Online Inverse Optimization
AlphaXiv
12

Optimal and Efficient Online Inverse Optimization

Affiliation: Google Research, Also with New York University, Also with Carnegie Mellon University, Google Research

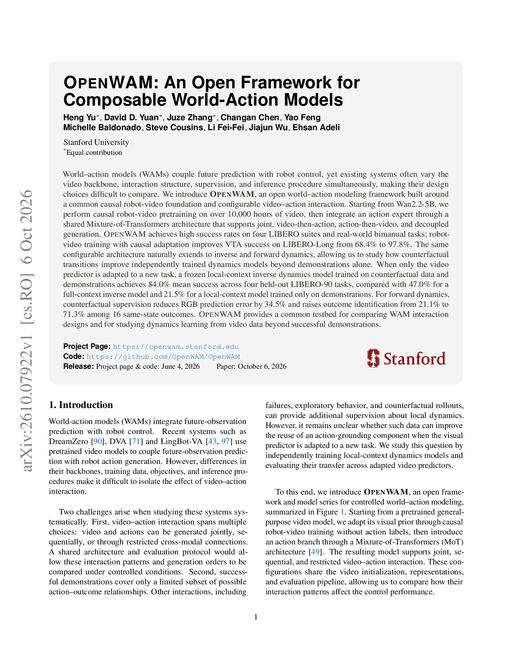
OpenWAM: An Open Framework for Composable World-Action Models
AlphaXiv
11

OpenWAM: An Open Framework for Composable World-Action Models

Affiliation: Stanford University, Stanford University

Reinforcement Learning
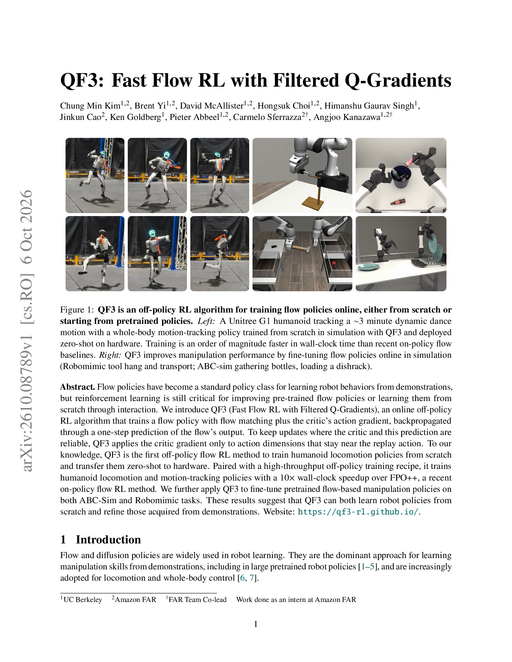
QF3: Fast Flow RL with Filtered Q-Gradients
AlphaXiv
5

QF3: Fast Flow RL with Filtered Q-Gradients

HuggingFace Daily Papers

Reinforcement Learning
CheckerBench: Can Long-Horizon Agents Synthesize Static-Analysis Checkers?
HuggingFace
52

CheckerBench: Can Long-Horizon Agents Synthesize Static-Analysis Checkers?

Hang He, Li Wang, Hao Chen, Yuchen Shao, Yuling Shi

Humanlaya Data Lab

NLP
Sherpa: Teaching LLMs to Teach Adaptively
HuggingFace
4

Sherpa: Teaching LLMs to Teach Adaptively

Weixian Xu, Yanzhe Zhang, Zora Zhiruo Wang, Changyu Chen, Diyi Yang

Social And Language Technology Lab

Machine Learning
Learning Functional Subspaces for Neural Network Compression
HuggingFace
3

Learning Functional Subspaces for Neural Network Compression

Massimo Bini, Anders Christensen, Stephan Alaniz, Judah Goldfeder, Ole Winther

Efficiency
Stepped MoE: Segment-Level Routing with Configurable Inference Complexity
HuggingFace
2

Stepped MoE: Segment-Level Routing with Configurable Inference Complexity

Arnav Kundu, Zhaoyang Xu, Bairu Hou, Chang Gao, Reed Li

Apple

Yang Ai Lab
Sensor-Language-Action Models
HuggingFace
1

Sensor-Language-Action Models

Yuekai Xu, Zitao Shuai, Yuzhe Yang

Health Intelligence Lab @ UCLA

Reinforcement Learning
Kinematic MeanFlow: One-Step Action Generation Policy for Robotic Foundation Models
HuggingFace
1

Kinematic MeanFlow: One-Step Action Generation Policy for Robotic Foundation Models

Jiawei Fan, Sifeng Wang, Yuqing Hou, Anbang Yao

Intel Labs China