The Research Desk.

The most upvoted and starred AI research crossing the community today.

Last Brew Time: Oct 1, 2026, 11:14 AM PT

X.com Research Buzz

Sycophantic Chatbots Cause Delusional Spiraling, Even in Ideal Bayesians
X.com
14856

Sycophantic Chatbots Cause Delusional Spiraling, Even in Ideal Bayesians

Kartik Chandra, Max Kleiman-Weiner, Jonathan Ragan-Kelley, Joshua B. Tenenbaum

MIT CSAIL, University of Washington, Seattle, MIT Department of Brain & Cognitive Sciences

SH9i9fSRyv
The Shape of Slop: Detecting AI-Written Blog Posts via Structural Features
X.com
6065

The Shape of Slop: Detecting AI-Written Blog Posts via Structural Features

AI models collapse when trained on recursively generated data
X.com
5051

AI models collapse when trained on recursively generated data

Ilia Shumailov, Zakhar Shumaylov, Ross Anderson

University of Oxford, University of Cambridge

AlphaXiv Trending

NLP
Tokenization: A Survey for Modern NLP
AlphaXiv
90

Tokenization: A Survey for Modern NLP

NLP
Context Language Models
AlphaXiv
63

Context Language Models

Affiliation: University of Washington, Affiliation: Meta Superintelligence Labs, Affiliation: University of Washington Affiliation: Meta Superintelligence Labs, University of Washington, Meta Superintelligence Labs

AlphaXiv
60

Gemini 4 Argon: our next era of frontier intelligence

Invent a Dataset: Measuring Dataset Generation Abilities with Zero Seed Data
AlphaXiv
22

Invent a Dataset: Measuring Dataset Generation Abilities with Zero Seed Data

views

NLP
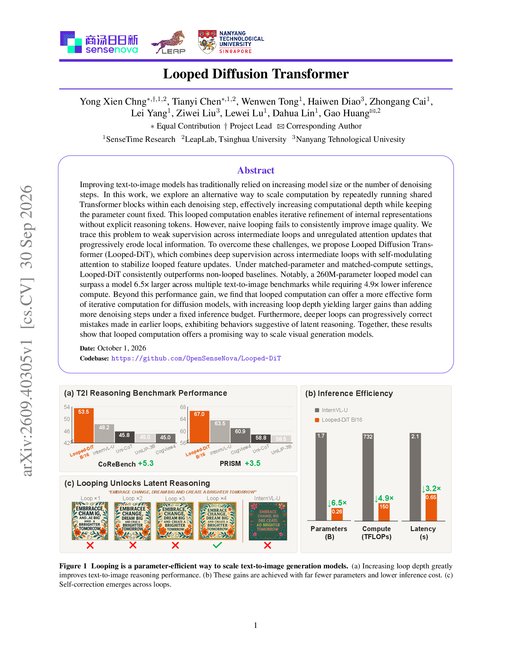
Looped Diffusion Transformer
AlphaXiv
18

Looped Diffusion Transformer

SenseTime Research, LeapLab, Tsinghua University

Reinforcement Learning
PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents
AlphaXiv
8

PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents

Princeton University NVIDIA, University of Maryland, https://research.nvidia.com/labs/lpr/pivotopd/

HuggingFace Daily Papers

Reinforcement Learning
MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution
HuggingFace
5

MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution

Prithwish Jana, Mononito Goswami, Hao Liu, Xinyu Li, Langlin Huang

Amazon

Reinforcement Learning
Rubric Rewards from Item Response Theory
HuggingFace
5

Rubric Rewards from Item Response Theory

Milad Yazdani, Yaser Souri, Xiren Zhou, Pranit Chawla, Dena Shahriari

Microsoft

Computer Vision
BIABench: Evaluating AI agents on real-world bioimage analysis tasks
HuggingFace
2

BIABench: Evaluating AI agents on real-world bioimage analysis tasks

Zixuan Pan, Davide Panzeri, Lukas Johanns, Marilin Moor, Yu Zhou

University of Notre Dame

Reinforcement Learning
DAGent: Evaluate-then-Grow Planning for Deep Research Agents
HuggingFace
2

DAGent: Evaluate-then-Grow Planning for Deep Research Agents

Hanwen Liu, Yuanfu Sun, Qiaoyu Tan

New York University

Reinforcement Learning
BiasReducer: Adaptive Bias Mitigation for Reward Models
HuggingFace
2

BiasReducer: Adaptive Bias Mitigation for Reward Models

Shuang Liu, Yongliang Miao, Yanguang Liu, Haoyi Xiong, Mengnan Du

Carnegie Mellon University

NLP
Prompted Identity Degrades Cooperation in Multi-Agent LLM Systems
HuggingFace
1

Prompted Identity Degrades Cooperation in Multi-Agent LLM Systems

Xavier Del Giudice, Alessio Palma, Matteo Migliarini, Fabio Galasso, Indro Spinelli